2x RTX 5060 Ti ਬਨਾਮ GB10: 32 GB VRAM, 128 GB ਯੂਨੀਫਾਈਡ ਮੈਮੋਰੀ ਤੋਂ ਕਿਉਂ ਹਾਰਦੀ ਹੈ
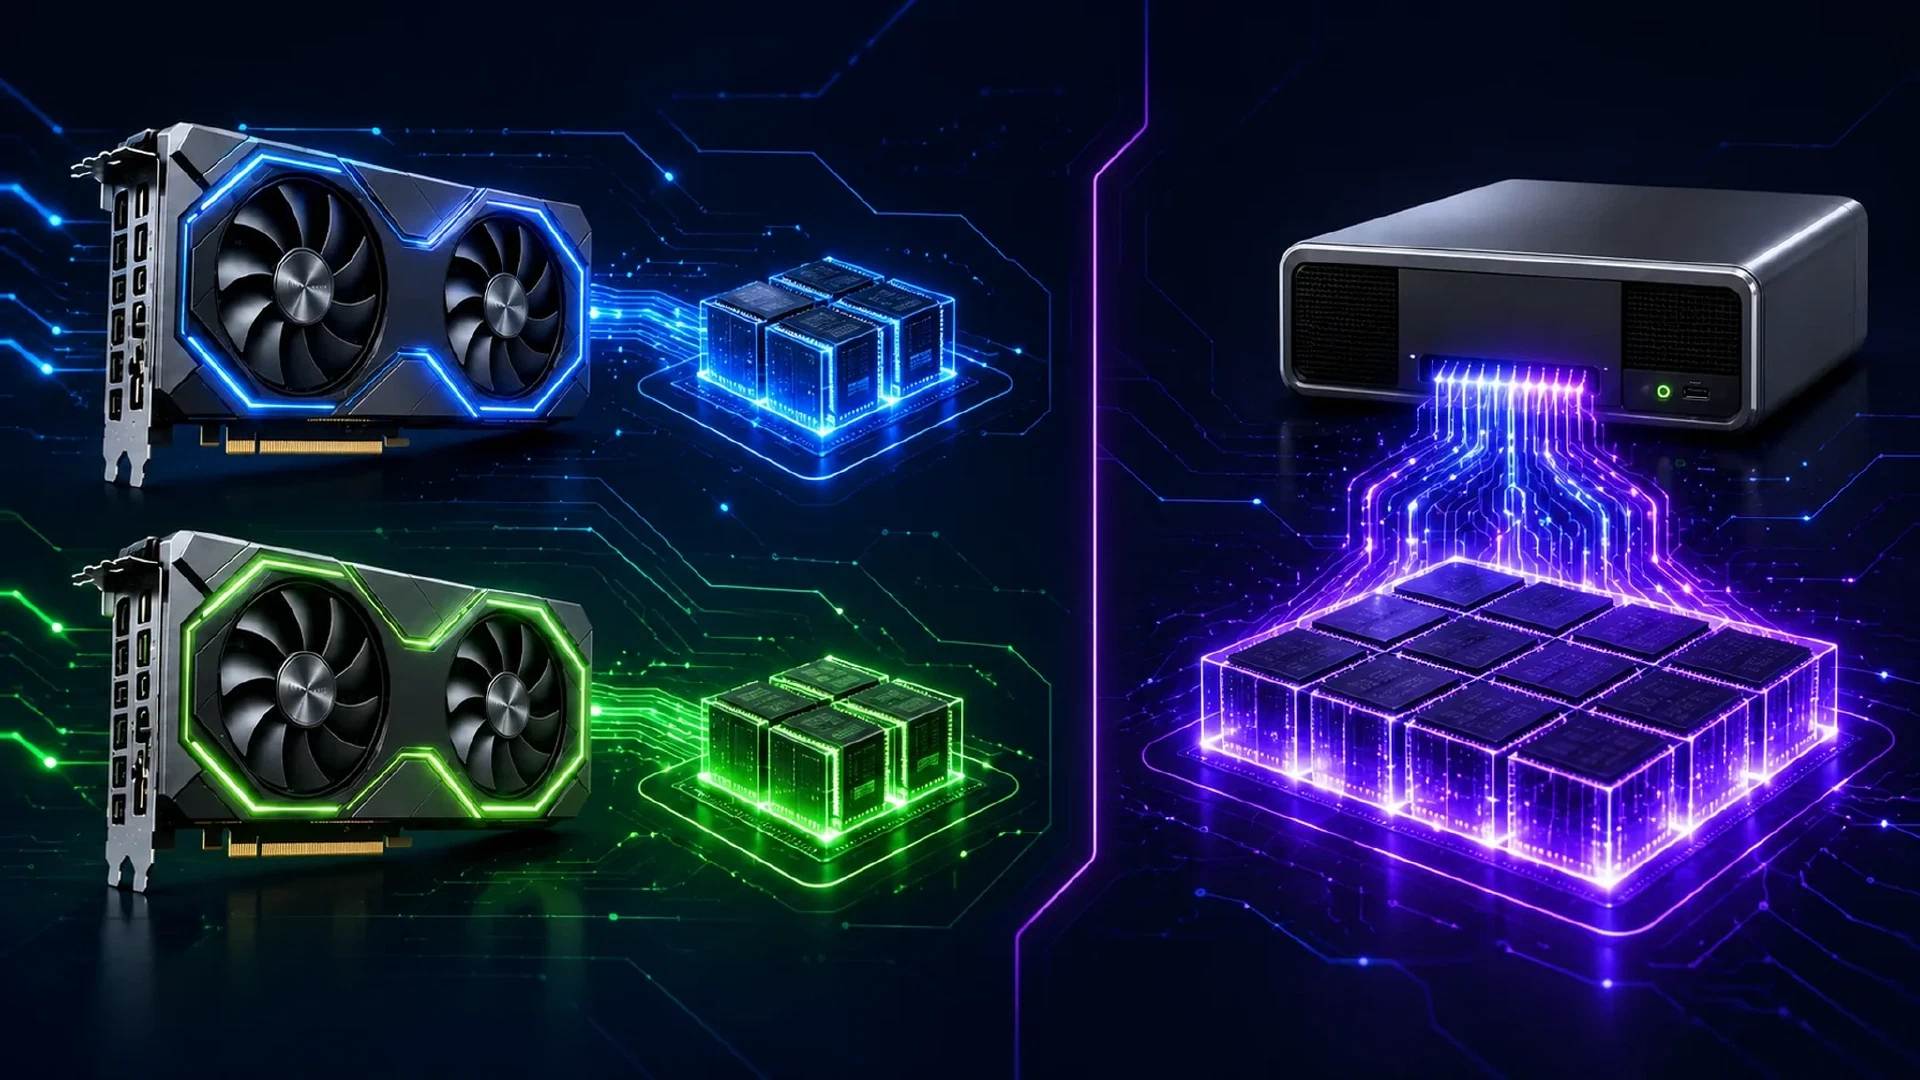
Table of Contents
ਦੋ RTX 5060 Ti 16 GB ਕਾਰਡ ਪਾਰਟਸ ਲਿਸਟ ਵਿੱਚ ਆਕਰਸ਼ਕ ਲੱਗਦੇ ਹਨ। ਇਹ 32 GB ਕੁੱਲ VRAM ਅਤੇ ਛੋਟੇ ਕਾਂਟੈਕਸਟ ਵਿੱਚ ਤੇਜ਼ ਪ੍ਰਾਂਪਟ ਪ੍ਰੋਸੈਸਿੰਗ ਦਿੰਦੇ ਹਨ। ਜਦੋਂ ਤੁਸੀਂ ਲੰਬੇ ਕਾਂਟੈਕਸਟ ਨਾਲ 27B ਮਾਡਲ ਚਲਾਉਂਦੇ ਹੋ, ਤੁਲਨਾ ਬਦਲ ਜਾਂਦੀ ਹੈ।
NVIDIA GB10 ਸਿਸਟਮ 128 GB ਕੋਹੀਰੈਂਟ ਯੂਨੀਫਾਈਡ ਮੈਮੋਰੀ ਵਰਤਦਾ ਹੈ। NVIDIA GB10 ਪਲੇਟਫਾਰਮ ਲਈ 128 GB LPDDR5x ਯੂਨੀਫਾਈਡ ਮੈਮੋਰੀ ਅਤੇ 140 W ਚਿਪ TDP ਦੱਸਦਾ ਹੈ। RTX 5060 Ti ਹਰ ਕਾਰਡ ਉੱਤੇ 16 GB GDDR7, 128-bit ਮੈਮੋਰੀ ਇੰਟਰਫੇਸ ਅਤੇ 180 W ਕੁੱਲ ਗ੍ਰਾਫਿਕਸ ਪਾਵਰ ਰੇਟਿੰਗ ਵਰਤਦਾ ਹੈ। NVIDIA RTX 5060 Ti specifications ਅਤੇ NVIDIA GB10 specifications ਹਾਰਡਵੇਅਰ ਦਾ ਫਰਕ ਸਪਸ਼ਟ ਕਰਦੇ ਹਨ।
ਮੁੱਦਾ ਸਧਾਰਨ ਹੈ। ਦੋ 16 GB ਕਾਰਡ ਇੱਕ ਤੇਜ਼ 32 GB ਮੈਮੋਰੀ ਪੂਲ ਨਹੀਂ ਬਣਾਉਂਦੇ। ਇਹ ਹੋਸਟ ਸਿਸਟਮ ਰਾਹੀਂ ਜੁੜੇ ਦੋ ਵੱਖਰੇ 16 GB ਪੂਲ ਬਣਾਉਂਦੇ ਹਨ। ਵੱਡੇ ਮਾਡਲ ਦੀ ਇਨਫਰੈਂਸ ਲਈ ਗੁੰਮ ਸਮਰੱਥਾ ਅਤੇ ਡਿਵਾਈਸਾਂ ਵਿਚਕਾਰ ਡਾਟਾ ਹਿਲਾਉਣਾ ਕਾਰਡਾਂ ਦੀ ਗਿਣਤੀ ਤੋਂ ਵੱਧ ਮਹੱਤਵ ਰੱਖਦਾ ਹੈ।
ਮੈਮੋਰੀ ਦੀ ਤੁਲਨਾ
| ਸਿਸਟਮ | ਮੈਮੋਰੀ | ਮੈਮੋਰੀ ਮਾਡਲ | ਦਰਜ ਕੀਤੀ ਪਾਵਰ |
|---|---|---|---|
| 2x RTX 5060 Ti 16 GB | 32 GB ਕੁੱਲ | ਦੋ ਵੱਖਰੇ GPU ਮੈਮੋਰੀ ਪੂਲ | 360 W GPU ਕੁੱਲ |
| GB10 ਸਿਸਟਮ | 128 GB | ਕੋਹੀਰੈਂਟ ਯੂਨੀਫਾਈਡ ਸਿਸਟਮ ਮੈਮੋਰੀ | 140 W GB10 TDP |
GB10 ਇਸ ਲਈ ਨਹੀਂ ਜਿੱਤਦਾ ਕਿ 128 GB LPDDR5x ਮੈਮੋਰੀ ਉੱਚ-ਪੱਧਰੀ ਡਿਸਕ੍ਰੀਟ GPU ਬੈਂਡਵਿਡਥ ਨਾਲ ਮਿਲਦੀ ਹੈ। ਫਾਇਦਾ ਸਮਰੱਥਾ ਅਤੇ ਪਲੇਸਮੈਂਟ ਤੋਂ ਆਉਂਦਾ ਹੈ। CPU ਅਤੇ GPU ਇੱਕੋ ਐਡਰੈੱਸ ਸਪੇਸ ਸਾਂਝੀ ਕਰਦੇ ਹਨ, ਇਸ ਲਈ ਮਾਡਲ, ਰਨਟਾਈਮ ਬਫਰ, ਐਕਟੀਵੇਸ਼ਨ ਅਤੇ ਕਾਂਟੈਕਸਟ ਡਾਟਾ ਨੂੰ ਦੋ ਅਲੱਗ 16 GB ਡਿਵਾਈਸਾਂ ਵਿੱਚ ਫਿੱਟ ਹੋਣ ਦੀ ਲੋੜ ਨਹੀਂ।
ਦੋ-ਕਾਰਡ ਸਿਸਟਮ ਨੂੰ ਵਧੇਰੇ ਮੁਸ਼ਕਲ ਪਲੇਸਮੈਂਟ ਸਮੱਸਿਆ ਆਉਂਦੀ ਹੈ। ਮਾਡਲ ਨੂੰ ਦੋਵੇਂ ਕਾਰਡਾਂ ਵਿੱਚ ਫਿੱਟ ਹੋਣਾ ਪੈਂਦਾ ਹੈ। ਇਨਫਰੈਂਸ ਰਨਟਾਈਮ ਨੂੰ ਉਨ੍ਹਾਂ ਵਿਚਕਾਰ ਡਾਟਾ ਭੇਜਣਾ ਪੈਂਦਾ ਹੈ। PCIe ਟ੍ਰੈਫਿਕ ਲੇਟੈਂਸੀ ਜੋੜਦਾ ਅਤੇ ਬੈਂਡਵਿਡਥ ਵਰਤਦਾ ਹੈ। NVIDIA ਦੀਆਂ ਵਿਸ਼ੇਸ਼ਤਾਵਾਂ ਅਨੁਸਾਰ RTX 5060 Ti NVLink ਵੀ ਸਹਾਇਤਾ ਨਹੀਂ ਕਰਦਾ।
ਬੈਂਚਮਾਰਕ ਨਤੀਜਾ
ਹੇਠਲੇ ਨਤੀਜੇ ਦਿੱਤੀ AI ਬੈਂਚਮਾਰਕ ਰਿਪੋਰਟ ਤੋਂ ਹਨ। ਰਿਪੋਰਟ ਇੱਕ ਬਿਨਾਂ-ਨਾਮ dual-GPU ਸਿਸਟਮ, ਜਿਸ ਨੂੰ 5060ti-x2 ਕਿਹਾ ਗਿਆ ਹੈ, ਦੀ GB10 ਸਿਸਟਮ ਨਾਲ ਤੁਲਨਾ ਕਰਦੀ ਹੈ। ਟੈਸਟ ਕਈ ਕਾਂਟੈਕਸਟ ਆਕਾਰਾਂ ਉੱਤੇ Qwen ਅਤੇ GPT-OSS ਨੂੰ ਕਵਰ ਕਰਦਾ ਹੈ।
ਮਾਡਲ ਸਿੱਧੇ Ollama ਤੋਂ ਆਏ। ਟੈਸਟ ਨੇ ਲਿਟਰਲ ਡਿਫਾਲਟ ਟੈਗ qwen3.8:27b ਅਤੇ gpt-oss:latest ਵਰਤੇ। ਕੋਈ custom Modelfile ਜਾਂ ਵਿਕਲਪਿਕ quantization ਨਹੀਂ ਚੁਣੀ ਗਈ। 5060ti-x2 ਸਿਸਟਮ ਨੇ PCIe Gen4 x16 ਅਤੇ ਬੈਂਚਮਾਰਕ ਸਮੇਂ ਉਪਲਬਧ ਸਭ ਤੋਂ ਨਵੇਂ NVIDIA Linux ਡਰਾਈਵਰ ਵਰਤੇ।
Qwen ਪ੍ਰਾਂਪਟ ਪ੍ਰੋਸੈਸਿੰਗ ਅਤੇ ਜਨਰੇਸ਼ਨ
| ਕਾਂਟੈਕਸਟ | 5060ti-x2 ਪ੍ਰਾਂਪਟ tok/s | 5060ti-x2 ਜਨਰੇਸ਼ਨ tok/s | GB10 ਪ੍ਰਾਂਪਟ tok/s | GB10 ਜਨਰੇਸ਼ਨ tok/s |
|---|---|---|---|---|
| 4K | 862.5 | 56.9 | 57.4 | 27.7 |
| 16K | 917.3 | 53.5 | 62.1 | 28.1 |
| 32K | 881.4 | 48.8 | 62.4 | 26.9 |
| 64K | 795.1 | 39.6 | 59.9 | 26.1 |
| 128K | 538.7 | 28.3 | 59.9 | 28.6 |
| 256K | 189.9 | 1.2 | 59.9 | 25.8 |
4K ਉੱਤੇ dual-card ਸਿਸਟਮ GB10 ਨਾਲੋਂ ਲਗਭਗ ਦੋ ਗੁਣਾ ਤੇਜ਼ ਜਨਰੇਟ ਕਰਦਾ ਹੈ। 64K ਉੱਤੇ ਅਗਵਾਈ ਲਗਭਗ 1.5 ਗੁਣਾ ਰਹਿ ਜਾਂਦੀ ਹੈ। 128K ਉੱਤੇ ਦੋਵੇਂ ਸਿਸਟਮ ਲਗਭਗ ਇੱਕੋ ਜਿਹੀ ਜਨਰੇਸ਼ਨ ਸਪੀਡ ਪਾਉਂਦੇ ਹਨ।
256K ਉੱਤੇ ਦੋ-ਕਾਰਡ ਬਿਲਡ ਦੀ ਜਿੱਤ ਨਹੀਂ ਦਿਸਦੀ। 5060ti-x2 ਬੇਨਤੀ ਸਿਰਫ 171,359 ਅਸਲ ਪ੍ਰਾਂਪਟ ਟੋਕਨਾਂ ਤੱਕ ਪਹੁੰਚੀ। ਜਨਰੇਸ਼ਨ 1.2 ਟੋਕਨ ਪ੍ਰਤੀ ਸਕਿੰਟ ਰਹਿ ਗਈ। GB10 ਨੇ ਪੂਰਾ 256K ਟੈਸਟ 25.8 ਟੋਕਨ ਪ੍ਰਤੀ ਸਕਿੰਟ ਨਾਲ ਪੂਰਾ ਕੀਤਾ।
ਟੈਸਟ ਕੀਤੇ 256K ਨਤੀਜੇ ਵਿੱਚ GB10 ਨੇ ਲਗਭਗ 21.5 ਗੁਣਾ ਤੇਜ਼ ਜਨਰੇਟ ਕੀਤਾ। ਇਸ ਤੋਂ ਵੱਧ ਮਹੱਤਵਪੂਰਨ ਹੈ ਕਿ GB10 ਨੇ ਮੰਗਿਆ ਕਾਂਟੈਕਸਟ ਪੂਰਾ ਕੀਤਾ। ਦੋ-ਕਾਰਡ ਸਿਸਟਮ ਨੇ ਉਹੀ ਵਰਕਲੋਡ ਨਹੀਂ ਦਿੱਤਾ।
ਕੁੱਲ VRAM ਗੁੰਮਰਾਹ ਕਿਉਂ ਕਰਦੀ ਹੈ
1. ਮਾਡਲ ਇੱਕ 32 GB ਕਾਰਡ ਨਹੀਂ ਵੇਖਦਾ
ਦੋ GPU ਆਪਣੀ ਮੈਮੋਰੀ ਨੂੰ ਇੱਕ ਸਥਾਨਕ ਐਡਰੈੱਸ ਸਪੇਸ ਵਿੱਚ ਨਹੀਂ ਮਿਲਾਉਂਦੇ। model-parallel ਰਨਟਾਈਮ ਲੇਅਰਾਂ ਜਾਂ ਟੈਂਸਰਾਂ ਨੂੰ ਡਿਵਾਈਸਾਂ ਵਿੱਚ ਵੰਡਦਾ ਹੈ। ਹਰ ਡਿਵਾਈਸ ਨੂੰ ਆਪਣੇ ਹਿੱਸੇ ਦੇ ਵਜ਼ਨ, ਅਸਥਾਈ ਬਫਰ ਅਤੇ ਕਾਂਟੈਕਸਟ ਸਟੇਟ ਦੇ ਹਿੱਸੇ ਲਈ ਥਾਂ ਚਾਹੀਦੀ ਹੈ।
ਇਸ ਲਈ ਵਰਤਣਯੋਗ ਸਮਰੱਥਾ ਸਧਾਰਨ ਜੋੜ ਨਾਲੋਂ ਘੱਟ ਹੁੰਦੀ ਹੈ। ਸਹੀ ਓਵਰਹੈੱਡ ਮਾਡਲ ਫਾਰਮੈਟ, quantization, ਇਨਫਰੈਂਸ ਬੈਕਐਂਡ, tensor split ਅਤੇ ਕਾਂਟੈਕਸਟ ਲੰਬਾਈ ਉੱਤੇ ਨਿਰਭਰ ਕਰਦਾ ਹੈ।
2. ਜਨਰੇਸ਼ਨ ਦੌਰਾਨ ਕਾਂਟੈਕਸਟ ਮੈਮੋਰੀ ਵਧਦੀ ਹੈ
ਮਾਡਲ ਵਜ਼ਨ ਮੈਮੋਰੀ ਬਜਟ ਦਾ ਸਿਰਫ ਇੱਕ ਹਿੱਸਾ ਹਨ। key-value cache, ਜਾਂ KV cache, ਪਿਛਲੇ ਟੋਕਨਾਂ ਦਾ attention ਡਾਟਾ ਰੱਖਦਾ ਹੈ। ਲੰਬੇ ਕਾਂਟੈਕਸਟ ਲਈ ਵੱਧ cache ਮੈਮੋਰੀ ਚਾਹੀਦੀ ਹੈ। 4K ਟੈਸਟ 128K ਜਾਂ 256K ਡਿਪਲੌਇਮੈਂਟ ਦੀ ਭਵਿੱਖਬਾਣੀ ਨਹੀਂ ਕਰਦਾ।
ਦਿੱਤੇ ਨਤੀਜੇ ਇਹ ਹੱਦ ਸਪਸ਼ਟ ਦਿਖਾਉਂਦੇ ਹਨ। ਕਾਂਟੈਕਸਟ ਵਧਣ ਨਾਲ dual-card ਸਿਸਟਮ ਦੀ ਪ੍ਰਾਂਪਟ-ਪ੍ਰੋਸੈਸਿੰਗ ਅਗਵਾਈ ਰਹਿੰਦੀ ਹੈ, ਫਿਰ ਜਨਰੇਸ਼ਨ ਕਾਰਗੁਜ਼ਾਰੀ ਘਟਦੀ ਹੈ। GB10 4K ਤੋਂ 256K ਤੱਕ ਲਗਭਗ 26 ਤੋਂ 29 ਜਨਰੇਸ਼ਨ ਟੋਕਨ ਪ੍ਰਤੀ ਸਕਿੰਟ ਰਹਿੰਦਾ ਹੈ।
3. PCIe ਟ੍ਰਾਂਸਫਰ ਕੀਮਤ ਜੋੜਦੇ ਹਨ
ਜਦੋਂ ਰਨਟਾਈਮ GPU ਵਿਚਕਾਰ ਐਕਟੀਵੇਸ਼ਨ ਜਾਂ ਟੈਂਸਰ ਹਿਲਾਉਂਦਾ ਹੈ, ਟ੍ਰਾਂਸਫਰ ਹੋਸਟ ਇੰਟਰਕਨੈਕਟ ਤੋਂ ਲੰਘਦਾ ਹੈ। ਇਸ ਨਾਲ synchronization points ਬਣਦੇ ਅਤੇ ਹਰ ਕਦਮ ਵਿੱਚ ਲੇਟੈਂਸੀ ਵਧਦੀ ਹੈ। ਜਦੋਂ ਵਰਕਲੋਡ ਵਾਰ ਵਾਰ ਡਿਵਾਈਸ ਸੀਮਾ ਪਾਰ ਕਰਦਾ ਹੈ, ਜੁਰਮਾਨਾ ਵਧਦਾ ਹੈ।
ਇਸ ਨਾਲ dual-GPU ਸਿਸਟਮ ਬੇਕਾਰ ਨਹੀਂ ਹੁੰਦਾ। ਮੈਮੋਰੀ ਪਲੇਸਮੈਂਟ ਨਤੀਜੇ ਦਾ ਹਿੱਸਾ ਹੈ। ਸਿਰਫ 4K ਪ੍ਰਾਂਪਟ ਪ੍ਰੋਸੈਸਿੰਗ ਦੱਸਣ ਵਾਲਾ ਬੈਂਚਮਾਰਕ ਇਹ ਲਾਗਤ ਛੱਡ ਦਿੰਦਾ ਹੈ।
4. ਪਾਵਰ ਕੁਸ਼ਲਤਾ ਸਿਸਟਮ ਪੱਧਰ ਦਾ ਫਾਇਦਾ ਹੈ
ਤੁਲਨਾ ਵਿੱਚ GB10 ਘੱਟ ਪਾਵਰ ਵਰਤਦਾ ਹੈ ਅਤੇ ਟੈਸਟ ਕੀਤੇ ਲੰਬੇ-ਕਾਂਟੈਕਸਟ ਵਰਕਲੋਡ ਲਈ ਵੱਧ ਮੈਮੋਰੀ ਸਮਰੱਥਾ ਦਿੰਦਾ ਹੈ। ਦੋ RTX 5060 Ti ਕਾਰਡ ਸਿਸਟਮ ਦੇ ਬਾਕੀ ਹਿੱਸਿਆਂ ਤੋਂ ਪਹਿਲਾਂ 360 W ਦੀ ਸਾਂਝੀ GPU ਪਾਵਰ ਲੈਂਦੇ ਹਨ। NVIDIA GB10 TDP 140 W ਦੱਸਦਾ ਹੈ।
GB10 ਛੋਟੇ ਕਾਂਟੈਕਸਟ ਦੀ ਅਧਿਕਤਮ ਸਪੀਡ ਦੇ ਬਦਲੇ ਸਮਰੱਥਾ, ਪੂਰਨਤਾ ਅਤੇ ਘੱਟ GPU ਪਾਵਰ ਦਿੰਦਾ ਹੈ। ਲੰਬੇ-ਕਾਂਟੈਕਸਟ Qwen ਇਨਫਰੈਂਸ ਲਈ ਇਹ ਬਦਲਾਅ ਮਹੱਤਵ ਰੱਖਦੇ ਹਨ।
5060ti-x2 ਸਿਸਟਮ ਦੀ ਕੀਮਤ ਬਹੁਤ ਘੱਟ ਹੈ
ਕਾਰਗੁਜ਼ਾਰੀ ਦੀ ਤੁਲਨਾ ਕੀਮਤ ਦੇ ਫਰਕ ਨੂੰ ਖਤਮ ਨਹੀਂ ਕਰਦੀ। ਇੱਕ ਪੂਰਾ dual RTX 5060 Ti 16 GB ਵਰਕਸਟੇਸ਼ਨ 10 ਅਕਤੂਬਰ 2026 ਨੂੰ $3,479 ਵਿੱਚ ਲਿਸਟ ਹੋਇਆ ਸੀ। ਇਸ ਵਿੱਚ Intel Ultra 7 265K, Z890 ਮਦਰਬੋਰਡ, 32 GB DDR5, 1 TB ਸਟੋਰੇਜ, 1,000 W ਪਾਵਰ ਸਪਲਾਈ ਅਤੇ ਦੋਵੇਂ GPU ਸ਼ਾਮਲ ਹਨ। ਪੂਰੀ dual-GPU ਵਰਕਸਟੇਸ਼ਨ ਲਿਸਟਿੰਗ ਵੇਖੋ ।
NVIDIA ਦੀ US marketplace 128 GB DGX Spark ਨੂੰ $6,950 ਵਿੱਚ ਲਿਸਟ ਕਰਦੀ ਹੈ। ਲਿਸਟਿੰਗ ਵਿੱਚ 128 GB ਕੋਹੀਰੈਂਟ ਯੂਨੀਫਾਈਡ ਮੈਮੋਰੀ ਅਤੇ 4 TB NVMe ਸਟੋਰੇਜ ਸ਼ਾਮਲ ਹੈ, ਪਰ ਸਿਸਟਮ out of stock ਦਿਖਾਈ ਦਿੰਦਾ ਹੈ। NVIDIA ਦੀ ਮੌਜੂਦਾ DGX Spark ਲਿਸਟਿੰਗ ਵੇਖੋ ।
AMD Ryzen AI Halo Developer Platform ਹੋਰ ਤੁਲਨਾ ਦਿੰਦਾ ਹੈ। ਇਹ Strix Halo ਸਿਸਟਮ Micro Center ਉੱਤੇ $3,999.99 ਵਿੱਚ 128 GB LPDDR5x ਯੂਨੀਫਾਈਡ ਮੈਮੋਰੀ ਅਤੇ 2 TB ਸਟੋਰੇਜ ਨਾਲ ਲਿਸਟ ਹੈ। Strix Halo ਅਕਸਰ GB10 ਸਿਸਟਮਾਂ ਵਰਗੀ practical local-AI ਸ਼੍ਰੇਣੀ ਵਿੱਚ ਆਉਂਦਾ ਹੈ, ਹਾਲਾਂਕਿ independent testing throughput ਅਤੇ software maturity ਵਿੱਚ GB10 ਨੂੰ ਅੱਗੇ ਮਾਪਦੀ ਹੈ। ਮੌਜੂਦਾ Micro Center Linux ਲਿਸਟਿੰਗ ਵੇਖੋ ਅਤੇ Strix Halo ਬਨਾਮ GB10 ਸਮੀਖਿਆ ਪੜ੍ਹੋ ।
| ਪੂਰਾ ਸਿਸਟਮ | 10 ਅਕਤੂਬਰ 2026 ਦੀ ਲਿਸਟ ਕੀਮਤ | ਕੀਮਤ ਫਰਕ |
|---|---|---|
| 5060ti-x2 ਵਰਕਸਟੇਸ਼ਨ | $3,479 | ਬੇਸਲਾਈਨ |
| AMD Ryzen AI Halo, Strix Halo | $3,999.99 | $520.99 ਵੱਧ |
| 128 GB GB10 DGX Spark | $6,950 | $3,471 ਵੱਧ |
GB10 ਵੱਡਾ ਯੂਨੀਫਾਈਡ ਮੈਮੋਰੀ ਪੂਲ, ਘੱਟ ਪਾਵਰ ਵਰਤੋਂ ਅਤੇ ਲੰਬੇ ਕਾਂਟੈਕਸਟ ਲਈ ਬਿਹਤਰ ਆਰਕੀਟੈਕਚਰ ਦਿੰਦਾ ਹੈ। AMD ਸਿਸਟਮ ਲਗਭਗ $4,000 ਵਿੱਚ ਉਹੀ 128 GB ਮੈਮੋਰੀ ਵਰਗ ਦਿੰਦਾ ਹੈ। ਟੈਕਸ ਅਤੇ ਸ਼ਿਪਿੰਗ ਤੋਂ ਪਹਿਲਾਂ 5060ti-x2 ਵਰਕਸਟੇਸ਼ਨ ਲਿਸਟ ਕੀਤੀ GB10 ਕੀਮਤ ਦਾ ਲਗਭਗ 50% ਹੈ। ਜਿਨ੍ਹਾਂ ਖਰੀਦਦਾਰਾਂ ਨੂੰ ਯੂਨੀਫਾਈਡ ਮੈਮੋਰੀ ਚਾਹੀਦੀ ਹੈ ਪਰ NVIDIA software stack ਨਹੀਂ, ਉਨ੍ਹਾਂ ਲਈ Strix Halo ਘੱਟ ਕੀਮਤ ਵਾਲਾ ਵਿਕਲਪ ਹੈ।
ਇਹ ਵੱਖਰੇ ਵਿਕਰੇਤਾਵਾਂ ਦੀਆਂ ਲਿਸਟ ਕੀਮਤਾਂ ਹਨ, ਨਿਯੰਤਰਿਤ retail basket ਨਹੀਂ। ਤੁਲਨਾ 5060ti-x2 ਸਿਸਟਮ ਲਈ ਘੱਟ system memory ਅਤੇ storage ਵੀ ਛੱਡਦੀ ਹੈ। ਕੀਮਤ ਫਰਕ ਫਿਰ ਵੀ ਮਹੱਤਵ ਰੱਖਦਾ ਹੈ, ਕਿਉਂਕਿ ਦੋਵੇਂ ਲਿਸਟਿੰਗ bare GPU prices ਦੀ ਥਾਂ ਪੂਰੇ ਵਰਤਣਯੋਗ ਕੰਪਿਊਟਰ ਦੱਸਦੀਆਂ ਹਨ। ਮੌਜੂਦਾ RTX 5060 Ti 16 GB ਕਾਰਡ ਲਗਭਗ $789 ਤੋਂ $830 ਹਰੇਕ ਹਨ, ਜੋ $429 launch MSRP ਤੋਂ ਕਾਫੀ ਵੱਧ ਹਨ। ਇਸ ਲਈ ਮੌਜੂਦਾ GPU ਕੀਮਤ ਉਛਾਲ ਵਿੱਚ ਵੀ ਦੋ-ਕਾਰਡ ਕੀਮਤ ਫਾਇਦਾ ਰਹਿੰਦਾ ਹੈ। ਮੌਜੂਦਾ RTX 5060 Ti ਕੀਮਤ ਜਾਂਚ ।
GPT-OSS ਨਤੀਜੇ ਨੂੰ ਵੱਖਰੇ ਤਰੀਕੇ ਨਾਲ ਦੇਖੋ
ਉਹੀ ਰਿਪੋਰਟ 4K ਤੋਂ 256K ਤੱਕ GPT-OSS ਲਈ ਮਜ਼ਬੂਤ 5060ti-x2 ਜਨਰੇਸ਼ਨ ਨਤੀਜੇ ਦਿਖਾਉਂਦੀ ਹੈ। GB10 4K ਤੋਂ 128K ਟੈਸਟ ਪੂਰੇ ਕਰਦਾ ਹੈ, ਪਰ 256K GPT-OSS ਟੈਸਟ unsupported ਦਰਜ ਹੈ।
GPT-OSS ਟੇਬਲ ਨੂੰ universal winner ਦੱਸਣ ਲਈ ਨਾ ਵਰਤੋ। 256K ਉੱਤੇ ਟੈਸਟ ਇੱਕੋ ਰੇਂਜ ਕਵਰ ਨਹੀਂ ਕਰਦੇ। Qwen ਨਤੀਜਾ ਸਾਫ਼ ਲੰਬੇ-ਕਾਂਟੈਕਸਟ ਤੁਲਨਾ ਦਿੰਦਾ ਹੈ, ਕਿਉਂਕਿ ਦੋਵੇਂ ਸਿਸਟਮ 256K ਨਤੀਜਾ ਦੱਸਦੇ ਹਨ, ਭਾਵੇਂ 5060ti-x2 ਰਨ ਸਿਰਫ 171,359 ਅਸਲ ਪ੍ਰਾਂਪਟ ਟੋਕਨਾਂ ਤੱਕ ਪਹੁੰਚਿਆ।
Qwen 3 27B ਬਿਲਡ ਲਈ ਇਸ ਦਾ ਅਰਥ
ਦੋ 16 GB ਕਾਰਡਾਂ ਦਾ ਸੈਟਅਪ ਛੋਟੇ ਕਾਂਟੈਕਸਟ ਵਿੱਚ quantized 27B ਮਾਡਲ ਚਲਾ ਸਕਦਾ ਹੈ। ਬੈਂਚਮਾਰਕ ਅਜਿਹੇ ਵਰਤੋਂ ਮਾਮਲੇ ਨੂੰ ਗਲਤ ਸਾਬਤ ਨਹੀਂ ਕਰਦਾ। ਡਾਟਾ ਇਹ ਦਾਅਵਾ ਗਲਤ ਸਾਬਤ ਕਰਦੇ ਹਨ ਕਿ 32 GB ਕੁੱਲ VRAM, 128 GB ਯੂਨੀਫਾਈਡ-ਮੈਮੋਰੀ ਸਿਸਟਮ ਜਿੰਨੀ practical headroom ਦਿੰਦੀ ਹੈ।
ਕਾਰਡ ਉੱਤੇ ਮਾਡਲ ਫਿੱਟ ਹੋਣਾ ਸਿਰਫ weight capacity ਸਾਬਤ ਕਰਦਾ ਹੈ। ਅਸਲ ਮੈਮੋਰੀ ਲੋੜ model weights, active context, KV cache, runtime buffers ਅਤੇ operating-system headroom ਦਾ ਜੋੜ ਹੈ। ਕਾਂਟੈਕਸਟ ਨੂੰ ਮਾਡਲ ਦੇ ਨਾਲ ਫਿੱਟ ਹੋਣਾ ਪੈਂਦਾ ਹੈ। ਲੋਡ ਹੋਣ ਵਾਲਾ ਪਰ working conversation ਲਈ ਥਾਂ ਤੋਂ ਬਿਨਾਂ ਮਾਡਲ ਵਰਤਣਯੋਗ long-context setup ਨਹੀਂ।
ਇਹ Is 16GB VRAM Enough for Serious Local LLM Work? ਵਿੱਚ ਦਿੱਤੀ sizing guidance ਨਾਲ ਮਿਲਦਾ ਹੈ, ਜੋ weights, context ਅਤੇ runtime allocations ਨੂੰ ਇੱਕ ਬਜਟ ਮੰਨਦੀ ਹੈ। 32GB VRAM guide for Qwen 27B ਵੀ ਦੋ-ਕਾਰਡ ਬਿਲਡ ਲਈ ਇਹੀ ਨਤੀਜਾ ਦਿੰਦੀ ਹੈ। ਕੁੱਲ ਸਮਰੱਥਾ usable headroom ਦੇ ਬਰਾਬਰ ਨਹੀਂ।
Qwen 3 27B ਡਿਪਲੌਇਮੈਂਟ ਲਈ ਹਾਰਡਵੇਅਰ ਖਰੀਦਣ ਤੋਂ ਪਹਿਲਾਂ ਚਾਰ ਸਵਾਲ ਪੁੱਛੋ:
- ਕੀ ਮੰਗੀ ਗਈ quantization runtime buffers ਨਾਲ ਫਿੱਟ ਹੁੰਦੀ ਹੈ? ਸਿਰਫ model weights ਮੈਮੋਰੀ ਲੋੜ ਪਰਿਭਾਸ਼ਿਤ ਨਹੀਂ ਕਰਦੇ।
- ਕੀ ਕਾਂਟੈਕਸਟ ਗੰਭੀਰ KV-cache ਦਬਾਅ ਤੋਂ ਬਿਨਾਂ ਫਿੱਟ ਹੁੰਦਾ ਹੈ? ਲੰਬੇ ਪ੍ਰਾਂਪਟ ਨਤੀਜਾ ਬਦਲਦੇ ਹਨ।
- ਕੀ ਰਨਟਾਈਮ ਤੇਜ਼ device split ਵਰਤਦਾ ਹੈ? PCIe transfers ਅਤੇ tensor placement ਹਰ generated token ਨੂੰ ਪ੍ਰਭਾਵਿਤ ਕਰਦੇ ਹਨ।
- ਕੀ ਸਿਸਟਮ target context ਪੂਰਾ ਕਰਦਾ ਹੈ? ਤੇਜ਼ 4K ਨਤੀਜਾ ਅਸਫਲ 256K workload ਦੀ ਭਰਪਾਈ ਨਹੀਂ ਕਰਦਾ।
ਦਿੱਤਾ ਟੈਸਟ dual-card ਸਿਸਟਮ ਲਈ ਆਖਰੀ ਸਵਾਲ ਦਾ ਜਵਾਬ ਦਿੰਦਾ ਹੈ। ਰਨ 256K Qwen ਬੇਨਤੀ ਦੌਰਾਨ 171,359 ਟੋਕਨਾਂ ਤੱਕ ਪਹੁੰਚਿਆ ਅਤੇ 1.2 ਟੋਕਨ ਪ੍ਰਤੀ ਸਕਿੰਟ ਉੱਤੇ ਜਨਰੇਟ ਕੀਤਾ। GB10 ਨੇ 256K ਨੂੰ 25.8 ਟੋਕਨ ਪ੍ਰਤੀ ਸਕਿੰਟ ਉੱਤੇ ਪੂਰਾ ਕੀਤਾ।
ਇਸ ਲੰਬੇ-ਕਾਂਟੈਕਸਟ ਵਰਕਲੋਡ ਲਈ, ਜਦੋਂ ਵਿਕਲਪ ਮਾਡਲ ਦੇ working set ਨੂੰ PCIe ਰਾਹੀਂ ਫੈਲਾਉਂਦਾ ਹੈ, ਯੂਨੀਫਾਈਡ ਮੈਮੋਰੀ ਬਿਹਤਰ ਆਰਕੀਟੈਕਚਰ ਹੈ। PCIe capacity workaround ਰਹਿੰਦਾ ਹੈ। PCIe ਉਹੀ memory pool, latency ਜਾਂ transfer path ਨਹੀਂ ਬਣਾਉਂਦਾ। local AI GPU context guide ਦੱਸਦੀ ਹੈ ਕਿ model weights, KV cache, tool output ਅਤੇ runtime buffers ਨੂੰ ਇਕੱਠੇ size ਕਿਉਂ ਕਰਨਾ ਚਾਹੀਦਾ ਹੈ। Ollama Qwen3.8 27B GPU benchmark ਇਹ ਵੀ ਦਿਖਾਉਂਦਾ ਹੈ ਕਿ long-context results ਨੂੰ short-context decode numbers ਤੋਂ ਵੱਖਰਾ ਧਿਆਨ ਚਾਹੀਦਾ ਹੈ।
ਫੈਸਲਾ
ਜਦੋਂ ਟੀਚਾ long-context 27B inference ਹੋਵੇ, ਦੋ RTX 5060 Ti 16 GB ਕਾਰਡ GB10 ਦਾ ਕਮਜ਼ੋਰ ਬਦਲ ਹਨ। ਇਹ ਛੋਟੇ ਕਾਂਟੈਕਸਟ ਆਕਾਰਾਂ ਉੱਤੇ ਵੱਧ prompt throughput ਦਿੰਦੇ ਹਨ। ਇਹ ਵੱਧ GPU power ਵੀ ਵਰਤਦੇ ਅਤੇ runtime ਨੂੰ split-memory layout ਦੇ ਸਾਹਮਣੇ ਰੱਖਦੇ ਹਨ।
ਦਿੱਤੇ ਨਤੀਜਿਆਂ ਵਿੱਚ GB10 prompt processing ਵਿੱਚ ਹੌਲਾ ਹੈ। ਸਿਸਟਮ ਵੱਧ power efficient ਹੈ, ਚਾਰ ਗੁਣਾ ਕੁੱਲ ਮੈਮੋਰੀ ਦਿੰਦਾ ਹੈ ਅਤੇ ਪੂਰਾ 256K Qwen ਟੈਸਟ ਵਰਤਣਯੋਗ generation speed ਨਾਲ ਪੂਰਾ ਕਰਦਾ ਹੈ।
ਜੇ ਤੁਸੀਂ ਛੋਟੇ prompts ਚਲਾਉਂਦੇ ਅਤੇ prompt ingestion ਨੂੰ ਤਰਜੀਹ ਦਿੰਦੇ ਹੋ, 5060ti-x2 ਦਾ ਸੀਮਿਤ ਮਾਮਲਾ ਹੈ। 27B ਮਾਡਲ ਲਈ ਵੱਡਾ ਯੂਨੀਫਾਈਡ ਮੈਮੋਰੀ ਪੂਲ ਬਿਹਤਰ ਚੋਣ ਹੈ, ਕਿਉਂਕਿ ਮਾਡਲ ਅਤੇ ਕਾਂਟੈਕਸਟ ਇੱਕ coherent working set ਸਾਂਝੇ ਕਰਦੇ ਹਨ। PCIe inference path ਵਿੱਚ ਆਉਣ ਤੋਂ ਬਾਅਦ ਵੀ ਯੂਨੀਫਾਈਡ ਮੈਮੋਰੀ ਬਿਹਤਰ ਰਹਿੰਦੀ ਹੈ।
ਬੈਂਚਮਾਰਕ ਇਹ ਨਹੀਂ ਦਿਖਾਉਂਦਾ ਕਿ ਦੋ RTX 5060 Ti ਕਾਰਡ Qwen 3 27B ਨੂੰ ਕਦੇ ਸ਼ੁਰੂ ਨਹੀਂ ਕਰਦੇ। ਡਾਟਾ ਦਿਖਾਉਂਦੇ ਹਨ ਕਿ ਮਾਡਲ ਸ਼ੁਰੂ ਕਰਨਾ ਅਤੇ ਵਰਕਲੋਡ ਚੰਗੀ ਤਰ੍ਹਾਂ ਚਲਾਉਣਾ ਵੱਖਰੀਆਂ ਗੱਲਾਂ ਹਨ।
ਬੈਂਚਮਾਰਕ ਸੀਮਾਵਾਂ
ਦਿੱਤੀ ਰਿਪੋਰਟ ਲਿਟਰਲ Ollama tags ਦੱਸਦੀ ਹੈ, ਪਰ resolved manifest digests, model revisions, CPU, power measurements ਜਾਂ cooling setup ਦਰਜ ਨਹੀਂ ਕਰਦੀ। ਰਿਪੋਰਟ 5060ti-x2 ਸਿਸਟਮ ਲਈ PCIe Gen4 x16 ਅਤੇ ਟੈਸਟ ਸਮੇਂ ਦੇ current NVIDIA Linux drivers ਵੀ ਦੱਸਦੀ ਹੈ। ਅੰਕੜਿਆਂ ਨੂੰ observed system comparison ਮੰਨੋ, ਹਰ RTX 5060 Ti ਜੋੜੇ ਅਤੇ ਹਰ GB10 implementation ਦੀ universal ranking ਨਹੀਂ।
ਉੱਪਰ ਦਿੱਤੀਆਂ hardware specifications NVIDIA ਤੋਂ ਹਨ। Performance figures ਇਸ ਲੇਖ ਲਈ ਦਿੱਤੇ benchmark data ਤੋਂ ਹਨ।
ਹਵਾਲੇ
- Ollama Qwen3.8 model library
- Ollama GPT-OSS model tags
- Is 16GB VRAM Enough for Serious Local LLM Work?
- 32GB VRAM for Qwen 27B
- Local AI GPU Context Guide
- Qwen3.8 27B GPU Benchmarks on Vast.ai
- Complete dual RTX 5060 Ti 16 GB workstation listing
- NVIDIA DGX Spark US marketplace listing
- AMD Ryzen AI Halo 128 GB Linux listing
- Tom’s Hardware Strix Halo versus GB10 review
- RTX 5060 Ti current price checks
Related Posts