AI ਸਾਈਬਰ ਸੁਰੱਖਿਆ ਸਰਟੀਫਿਕੇਸ਼ਨ: ਅਮਲ ਤੋਂ ਪਿੱਛੇ

Table of Contents
ਅਸੀਂ ਪ੍ਰੀਖਿਆਵਾਂ ਦਿੱਤੀਆਂ। ਪਾਸ ਹੋਏ। ਸਰਟੀਫਿਕੇਟ ਮਿਲੇ, ਪਰ ਨਾਲ ਅਜਿਹੀ ਨਿਰਾਸ਼ਾ ਵੀ ਆਈ ਜਿਸ ਬਾਰੇ ਮੈਂ ਸਪਸ਼ਟ ਗੱਲ ਕਰਨੀ ਚਾਹੁੰਦਾ ਹਾਂ।
ਇਹ ਪ੍ਰੋਗਰਾਮ ਬਣਾਉਣ ਵਾਲੇ ਲੋਕਾਂ ਬਾਰੇ ਸ਼ਿਕਾਇਤ ਨਹੀਂ ਹੈ। ਉਹ ਅਧੂਰੀ ਸਮੱਗਰੀ ਨਾਲ ਕੰਮ ਕਰ ਰਹੇ ਹਨ। AI ਸੁਰੱਖਿਆ ਇੱਕ ਖੇਤਰ ਵਜੋਂ ਨਵੀਂ ਹੈ। ਹਮਲਿਆਂ ਬਾਰੇ ਖੋਜ, ਰੱਖਿਆ ਦੇ ਸਾਧਨਾਂ ਨਾਲੋਂ ਤੇਜ਼ੀ ਨਾਲ ਅੱਗੇ ਵੱਧ ਰਹੀ ਹੈ। ਗਵਰਨੈਂਸ ਢਾਂਚੇ ਇੰਜੀਨੀਅਰਿੰਗ ਮਾਰਗਦਰਸ਼ਨ ਤੋਂ ਪਹਿਲਾਂ ਆ ਗਏ।
ਸਮੱਸਿਆ ਸਰਟੀਫਿਕੇਸ਼ਨ ਵਿੱਚ ਸਿਖਾਈ ਜਾਣ ਵਾਲੀ ਗੱਲ ਅਤੇ ਉਤਪਾਦਨ ਵਿੱਚ AI ਪ੍ਰਣਾਲੀਆਂ ਨੂੰ ਸੁਰੱਖਿਅਤ ਕਰਨ ਲਈ ਲੋੜੀਂਦੀ ਜਾਣਕਾਰੀ ਵਿਚਲਾ ਫਰਕ ਹੈ।
ਤਿੰਨ ਪਰਤਾਂ ਜਿਨ੍ਹਾਂ ਨੂੰ ਅਕਸਰ ਗਡ਼ਮਡ਼ ਕੀਤਾ ਜਾਂਦਾ ਹੈ
ਕੀ ਗੁੰਮ ਹੈ, ਇਹ ਦੱਸਣ ਤੋਂ ਪਹਿਲਾਂ ਮੌਜੂਦਾ ਚੀਜ਼ਾਂ ਨੂੰ ਵੱਖ ਕਰਨਾ ਲਾਭਦਾਇਕ ਹੈ।
ਪਹਿਲੀ ਪਰਤ ਗਵਰਨੈਂਸ ਹੈ। NIST AI Risk Management Framework (AI RMF 1.0, 2023), ISO/IEC 42001:2023 ਅਤੇ EU AI Act ਵਰਗੇ ਦਸਤਾਵੇਜ਼ ਸੰਗਠਨ ਅਤੇ ਪ੍ਰਕਿਰਿਆ ਦੇ ਪੱਧਰ ਉੱਤੇ ਕੰਮ ਕਰਦੇ ਹਨ। ਇਹ ਦੱਸਦੇ ਹਨ ਕਿ AI ਜੋਖਮ ਕਿਵੇਂ ਸੰਭਾਲਣਾ, ਨਿਗਰਾਨੀ ਕਿਵੇਂ ਬਣਾਉਣੀ ਅਤੇ ਜਵਾਬਦੇਹੀ ਕਿਵੇਂ ਦਰਜ ਕਰਨੀ ਹੈ। ਇਹ ਜਾਣਬੁੱਝ ਕੇ ਤਕਨੀਕੀ ਨਿਯੰਤਰਣ ਤੈਅ ਕਰਨ ਦੀ ਥਾਂ ਗਵਰਨੈਂਸ ਉੱਤੇ ਕੇਂਦਰਿਤ ਹਨ। ਇਹ ਡਿਜ਼ਾਇਨ ਮੁਤਾਬਕ ਹੈ।
ਦੂਜੀ ਪਰਤ ਖਤਰਿਆਂ ਦੀ ਵਰਗੀਕਰਨ ਹੈ। MITRE ATLAS, ATT&CK ਵਰਗੇ ਫਾਰਮੈਟ ਵਿੱਚ AI ਪ੍ਰਣਾਲੀਆਂ ਵਿਰੁੱਧ ਵਿਰੋਧੀ ਤਰੀਕਿਆਂ ਦਾ ਦਸਤਾਵੇਜ਼ ਬਣਾਉਂਦਾ ਹੈ। OWASP Top 10 for Large Language Model Applications, ਤਾਇਨਾਤ LLMs ਲਈ ਮਹੱਤਵਪੂਰਨ ਹਮਲਾ-ਕਿਸਮਾਂ ਦੀ ਸੂਚੀ ਦਿੰਦਾ ਹੈ। ਇਹ ਦਸਤਾਵੇਜ਼ ਹਮਲਿਆਂ ਦੇ ਨਾਮ ਅਤੇ ਉਨ੍ਹਾਂ ਦੇ ਕੰਮ ਕਰਨ ਦਾ ਢੰਗ ਦੱਸਦੇ ਹਨ। ਇਹ ਬਚਾਅ ਦੇ ਤਰੀਕੇ ਨਿਰਧਾਰਤ ਨਹੀਂ ਕਰਦੇ।
ਤੀਜੀ ਪਰਤ ਤਕਨੀਕੀ ਮਾਰਗਦਰਸ਼ਨ ਹੈ। ਇਸ ਵਿੱਚ Google’s Secure AI Framework (SAIF), Microsoft’s AI Security SDL, OWASP AI Exchange, NIST AI 600-1 (Generative AI Profile) ਅਤੇ Anthropic, OpenAI, Meta ਆਦਿ ਦੇ ਵਿਕਰੇਤਾ-ਵਿਸ਼ੇਸ਼ ਸੁਰੱਖਿਆ ਦਸਤਾਵੇਜ਼ ਸ਼ਾਮਲ ਹਨ। ਇਹ ਸੁਰੱਖਿਅਤ deployment, ਮੁਲਾਂਕਣ ਅਮਲ ਅਤੇ runtime ਨਿਯੰਤਰਣ ਲਈ ਇੰਜੀਨੀਅਰਿੰਗ ਪੱਧਰ ਦਾ ਮਾਰਗਦਰਸ਼ਨ ਦਿੰਦੇ ਹਨ।
ਜ਼ਿਆਦਾਤਰ AI ਗਵਰਨੈਂਸ ਸਰਟੀਫਿਕੇਸ਼ਨ ਪਹਿਲੀ ਪਰਤ ਨੂੰ ਚੰਗੀ ਤਰ੍ਹਾਂ ਸਿਖਾਉਂਦੇ ਹਨ। ਦੂਜੀ ਪਰਤ ਦਾ ਸੰਖੇਪ ਜ਼ਿਕਰ ਹੁੰਦਾ ਹੈ। ਤੀਜੀ ਪਰਤ ਨੂੰ ਵਿਰਲੇ ਹੀ ਛੂਹਦੇ ਹਨ।
ਸਰਟੀਫਿਕੇਸ਼ਨ ਕੀ ਸਿਖਾਉਂਦੇ ਹਨ
ਇਸ ਵੇਲੇ ਉਪਲਬਧ AI ਗਵਰਨੈਂਸ ਅਤੇ ਸੁਰੱਖਿਆ ਸਰਟੀਫਿਕੇਸ਼ਨ, ਜਿਵੇਂ IAPP AI Governance Professional (AIGP), ISACA AI Fundamentals Certificate, ISO 42001 ਸਰਟੀਫਿਕੇਸ਼ਨ ਅਤੇ CompTIA AI+, ਵਿਸ਼ਿਆਂ ਦੇ ਮਿਲਦੇ-ਜੁਲਦੇ ਸਮੂਹ ਨੂੰ ਕਵਰ ਕਰਦੇ ਹਨ।
ਤੁਸੀਂ NIST AI RMF ਅਤੇ ਇਸ ਦੇ ਚਾਰ ਕੰਮ, Govern, Map, Measure ਅਤੇ Manage, ਨੂੰ ਆਪਣੇ ਸੰਗਠਨ ਦੀ AI ਤਾਇਨਾਤੀ ਨਾਲ ਜੋੜਨਾ ਸਿੱਖਦੇ ਹੋ। ਤੁਸੀਂ EU AI Act ਦੇ ਜੋਖਮ ਪੱਧਰ ਅਤੇ ਉੱਚ-ਜੋਖਮ ਪ੍ਰਣਾਲੀਆਂ ਲਈ conformity assessment ਦਾ ਢੰਗ ਸਿੱਖਦੇ ਹੋ। ਤੁਸੀਂ ਪੱਖਪਾਤ, ਨਿਰਪੱਖਤਾ, ਪਾਰਦਰਸ਼ਤਾ ਅਤੇ ਜਵਾਬਦੇਹੀ ਨੂੰ ਗਵਰਨੈਂਸ ਦੇ ਅਸੂਲਾਂ ਵਜੋਂ ਸਿੱਖਦੇ ਹੋ। ਤੁਸੀਂ AI ਗਵਰਨੈਂਸ ਨੀਤੀਆਂ ਲਿਖਣ ਅਤੇ ਪ੍ਰਭਾਵ ਮੁਲਾਂਕਣ ਕਰਨ ਬਾਰੇ ਸਿੱਖਦੇ ਹੋ।
ਇਹ ਅਸਲ ਹੁਨਰ ਹਨ। ਸੰਗਠਨਾਂ ਨੂੰ ਗਵਰਨੈਂਸ ਢਾਂਚੇ ਸਮਝਣ ਵਾਲੇ ਲੋਕ ਚਾਹੀਦੇ ਹਨ। ਉਨ੍ਹਾਂ ਨੂੰ ਅਜਿਹੇ ਲੋਕ ਚਾਹੀਦੇ ਹਨ ਜੋ NIST AI RMF ਪੜ੍ਹ ਕੇ ਸਮਝਣ ਕਿ ਇਹ ਉਨ੍ਹਾਂ ਨੂੰ ਕੀ ਬਣਾਉਣ ਲਈ ਕਹਿੰਦਾ ਹੈ।
ਜਿਨ੍ਹਾਂ ਗੱਲਾਂ ਨੂੰ ਸਰਟੀਫਿਕੇਸ਼ਨ ਇੰਨੀ ਡੂੰਘਾਈ ਨਾਲ ਨਹੀਂ ਸਿਖਾਉਂਦੇ:
- ਹਮਲਾਵਰ ਇਸ ਵੇਲੇ ਉਤਪਾਦਨ ਦੀਆਂ AI ਪ੍ਰਣਾਲੀਆਂ ਨਾਲ ਕਿਵੇਂ ਸਮਝੌਤਾ ਕਰਦੇ ਹਨ
- ਪ੍ਰੌਂਪਟ ਇੰਜੈਕਸ਼ਨ ਲਈ ਬਹੁ-ਪਰਤੀ ਬਚਾਅ ਅਮਲ ਵਿੱਚ ਕਿਵੇਂ ਦਿਸਦਾ ਹੈ ਅਤੇ ਕੋਈ ਇਕੱਲਾ ਨਿਯੰਤਰਣ ਇਸ ਨੂੰ ਕਿਉਂ ਨਹੀਂ ਰੋਕਦਾ
- deployment ਤੋਂ ਪਹਿਲਾਂ ਮਾਡਲਾਂ ਦੀ ਅਖੰਡਤਾ ਕਿਵੇਂ ਜਾਂਚਣੀ ਹੈ
- AI-ਵਿਸ਼ੇਸ਼ red teaming ਵਿੱਚ ਕੀ ਸ਼ਾਮਲ ਹੈ ਅਤੇ ਇਸ ਦਾ ਦਾਇਰਾ ਕਿਵੇਂ ਤੈਅ ਕਰਨਾ ਹੈ
- launch ਤੋਂ ਪਹਿਲਾਂ ਵਿਰੋਧੀ inputs ਵਿਰੁੱਧ ਮਾਡਲ ਦੇ ਵਿਹਾਰ ਦਾ ਮੁਲਾਂਕਣ ਕਿਵੇਂ ਕਰਨਾ ਹੈ
- inference ਸਮੇਂ AI observability ਕਿਹੋ ਜਿਹੀ ਹੁੰਦੀ ਹੈ
- AI incident response, ਆਮ IR playbooks ਤੋਂ ਕਿਵੇਂ ਵੱਖਰਾ ਹੈ
- tools ਅਤੇ ਬਾਹਰੀ integrations ਵਾਲੇ AI agents ਨੂੰ ਸੁਰੱਖਿਅਤ ਕਰਨ ਲਈ ਕੀ ਲੋੜੀਂਦਾ ਹੈ
NIST AI RMF ਗਵਰਨੈਂਸ ਹੈ, ਇੰਜੀਨੀਅਰਿੰਗ ਨਹੀਂ
NIST AI RMF ਇੱਕ ਚੰਗੀ ਤਰ੍ਹਾਂ ਬਣਾਇਆ ਦਸਤਾਵੇਜ਼ ਹੈ। NIST ਨੇ ਇਸ ਨੂੰ ਤਕਨਾਲੋਜੀ-ਨਿਰਪੱਖ, ਖੇਤਰ-ਨਿਰਪੱਖ ਅਤੇ ਵੱਖਰੇ AI ਵਿਕਾਸ ਤਰੀਕਿਆਂ ਲਈ ਲਾਗੂ ਹੋਣ ਯੋਗ ਬਣਾਇਆ ਹੈ। ਇਸ ਕਰਕੇ ਇਹ ਢਾਂਚਾ ਕਈ ਹਾਲਾਤਾਂ ਵਿੱਚ ਲਾਗੂ ਹੁੰਦਾ ਹੈ।
ਇਸ ਦਾ ਮਤਲਬ ਇਹ ਵੀ ਹੈ ਕਿ ਢਾਂਚਾ ਖਾਸ ਹਮਲਾ-ਕਿਸਮਾਂ ਲਈ ਤਕਨੀਕੀ ਨਿਯੰਤਰਣ ਨਹੀਂ ਦੱਸਦਾ। ਜੇ ਤੁਹਾਡਾ ਸੰਗਠਨ AI RMF ਪੂਰੀ ਤਰ੍ਹਾਂ ਅਪਣਾਏ ਅਤੇ ਇਸ ਦੇ ਸਾਰੇ ਕੰਮ ਆਪਣੀ AI ਤਾਇਨਾਤੀ ਨਾਲ ਜੋੜੇ, ਤਾਂ ਜੋਖਮ ਪ੍ਰਕਿਰਿਆਵਾਂ ਦਰਜ ਹੋਣਗੀਆਂ। ਪਰ ਤਾਇਨਾਤ language model ਉੱਤੇ prompt injection ਵਿਰੁੱਧ ਬਚਾਅ ਲਾਜ਼ਮੀ ਤੌਰ ਉੱਤੇ ਨਹੀਂ ਬਣੇਗਾ।
NIST ਇਸ ਗੱਲ ਨੂੰ ਮੰਨਦਾ ਹੈ। 2024 ਵਿੱਚ ਜਾਰੀ NIST AI 600-1, Generative AI Profile, AI RMF ਨੂੰ ਖਾਸ ਤੌਰ ਉੱਤੇ generative AI ਅਤੇ ਵੱਡੇ ਭਾਸ਼ਾ ਮਾਡਲਾਂ ਲਈ ਵਧਾਉਂਦਾ ਹੈ। ਇਹ prompt injection, data poisoning ਅਤੇ ਜਾਣਕਾਰੀ ਦੇ ਖਤਰਿਆਂ ਸਮੇਤ ਜੋਖਮਾਂ ਨੂੰ ਮੁੱਢਲੇ AI RMF ਨਾਲੋਂ ਵਧੇਰੇ ਖਾਸੀਅਤ ਨਾਲ ਕਵਰ ਕਰਦਾ ਹੈ। ਜੇ ਤੁਹਾਡੇ ਸਰਟੀਫਿਕੇਸ਼ਨ ਵਿੱਚ AI 600-1 ਤੋਂ ਬਿਨਾਂ ਸਿਰਫ਼ ਮੁੱਢਲਾ AI RMF ਸੀ, ਤਾਂ ਤੁਸੀਂ ਮੌਜੂਦਾ ਤਾਇਨਾਤ ਪ੍ਰਣਾਲੀਆਂ ਲਈ ਸਭ ਤੋਂ ਸਬੰਧਤ ਦਸਤਾਵੇਜ਼ ਛੱਡ ਦਿੱਤਾ।
ISO 42001 ਅਤੇ management system ਦੀ ਤੁਲਨਾ
ISO 42001:2023 AI management system ਦਾ ਮਿਆਰ ਹੈ। ਇਹ ਸੰਗਠਨ ਪੱਧਰ ਉੱਤੇ AI ਵਿਕਾਸ ਅਤੇ ਤਾਇਨਾਤੀ ਦੇ ਗਵਰਨੈਂਸ ਲਈ ਢਾਂਚਾ ਦਿੰਦਾ ਹੈ। ਸੁਰੱਖਿਆ ਪੇਸ਼ੇਵਰਾਂ ਨੂੰ ਇਸ ਵਿੱਚ ਜਾਣਕਾਰੀ ਸੁਰੱਖਿਆ ਲਈ ISO 27001 ਨਾਲ ਮਿਲਾਪ ਦਿਸੇਗਾ।
ISO 27001 ਵਿਆਪਕ ਤੌਰ ਉੱਤੇ ਅਪਣਾਇਆ ਗਿਆ ਹੈ। ਸਰਟੀਫਾਈਡ ਸੰਗਠਨਾਂ ਉੱਤੇ ਫਿਰ ਵੀ ਹਮਲੇ ਹੁੰਦੇ ਹਨ। ਸਰਟੀਫਿਕੇਸ਼ਨ ਦਰਜ ਕਰਦਾ ਹੈ ਕਿ management system ਮੌਜੂਦ ਹੈ, ਨਿਰਧਾਰਤ ਪ੍ਰਕਿਰਿਆ ਮੰਨਦਾ ਹੈ ਅਤੇ ਸਮੀਖਿਆ ਹੁੰਦੀ ਹੈ। ਇਹ ਪ੍ਰਮਾਣਿਤ ਨਹੀਂ ਕਰਦਾ ਕਿ ਉਸ ਪ੍ਰਕਿਰਿਆ ਅਧੀਨ ਪ੍ਰਣਾਲੀਆਂ ਉਨ੍ਹਾਂ ਵਿਰੁੱਧ ਹੋ ਰਹੇ ਹਮਲਿਆਂ ਦਾ ਟਾਕਰਾ ਕਰਦੀਆਂ ਹਨ।
ISO 42001 ਸੰਗਠਨਾਤਮਕ ਅਨੁਸ਼ਾਸਨ ਦਿੰਦਾ ਹੈ। ਸਰਟੀਫਿਕੇਸ਼ਨ ਮਿਲਣ ਦਾ ਮਤਲਬ ਹੈ ਕਿ ਤੁਹਾਡੀਆਂ AI ਪ੍ਰਕਿਰਿਆਵਾਂ ਦਰਜ, ਸਮੀਖਿਆਸ਼ੁਦਾ ਅਤੇ ਗਵਰਨੈਂਸ ਅਧੀਨ ਹਨ। ਇਸ ਨਾਲ ਇਹ ਸਾਬਤ ਨਹੀਂ ਹੁੰਦਾ ਕਿ ਤਾਇਨਾਤ ਮਾਡਲ ਵਿਰੋਧੀ ਹਾਲਾਤਾਂ ਵਿੱਚ ਲਗਾਤਾਰ ਠੀਕ ਨਤੀਜੇ ਦਿੰਦੇ ਹਨ, agents ਨਿਰਧਾਰਤ trust boundaries ਅੰਦਰ ਕੰਮ ਕਰਦੇ ਹਨ ਜਾਂ fine-tuned ਮਾਡਲ ਤਸਦੀਕ ਕੀਤੇ training data ਨਾਲ ਬਣੇ ਹਨ।
ਇਹੀ ਫਰਕ ISO 27001 ਵਿੱਚ ਵੀ ਹੈ। ਰਵਾਇਤੀ ਸਾਈਬਰ ਸੁਰੱਖਿਆ ਵਿੱਚ ਅਸੀਂ ਇਸ ਹਕੀਕਤ ਨਾਲ ਕੰਮ ਕਰਨਾ ਸਿੱਖਿਆ। ਸਾਨੂੰ ਇਹ ਦਿਖਾਵਾ ਨਹੀਂ ਕਰਨਾ ਚਾਹੀਦਾ ਕਿ AI ਗਵਰਨੈਂਸ ਸਰਟੀਫਿਕੇਸ਼ਨ ਇਹ ਫਰਕ ਮਿਟਾ ਦਿੰਦੇ ਹਨ, ਜਦਕਿ ਉਨ੍ਹਾਂ ਦੀ ਬਣਤਰ ਵਿੱਚ ਉਹੀ ਹੱਦ ਹੈ।
EU AI Act ਨਤੀਜੇ ਮੰਗਦਾ ਹੈ, ਇੰਜੀਨੀਅਰਿੰਗ ਵਿਸ਼ੇਸ਼ਤਾਵਾਂ ਨਹੀਂ
EU AI Act, AI ਪ੍ਰਣਾਲੀਆਂ ਨੂੰ ਜੋਖਮ ਪੱਧਰ ਮੁਤਾਬਕ ਵੰਡਦਾ ਹੈ: ਅਸਵੀਕਾਰਯੋਗ (ਪਾਬੰਦੀਸ਼ੁਦਾ), ਉੱਚ ਜੋਖਮ (conformity assessment ਲੋੜੀਂਦਾ), ਸੀਮਤ ਜੋਖਮ (ਪਾਰਦਰਸ਼ਤਾ ਦੀਆਂ ਜ਼ਿੰਮੇਵਾਰੀਆਂ) ਅਤੇ ਘੱਟੋ-ਘੱਟ ਜੋਖਮ (ਖਾਸ ਲੋੜਾਂ ਨਹੀਂ)।
ਉੱਚ-ਜੋਖਮ ਪ੍ਰਣਾਲੀਆਂ, ਜਿਨ੍ਹਾਂ ਵਿੱਚ ਮਹੱਤਵਪੂਰਨ ਢਾਂਚੇ, ਬਾਇਓਮੈਟ੍ਰਿਕ ਪਛਾਣ, ਭਰਤੀ ਜਾਂਚ, ਸਿੱਖਿਆ ਅਤੇ ਕਾਨੂੰਨ ਲਾਗੂ ਕਰਨ ਵਾਲੀਆਂ ਪ੍ਰਣਾਲੀਆਂ ਸ਼ਾਮਲ ਹਨ, ਲਈ ਤਕਨੀਕੀ ਦਸਤਾਵੇਜ਼, ਮਨੁੱਖੀ ਨਿਗਰਾਨੀ ਅਤੇ ਮਜ਼ਬੂਤੀ ਦੀਆਂ ਲੋੜਾਂ ਹਨ। ਕਾਨੂੰਨ ਸਪਸ਼ਟ ਤੌਰ ਉੱਤੇ ਮੰਗਦਾ ਹੈ ਕਿ ਉੱਚ-ਜੋਖਮ AI ਪ੍ਰਣਾਲੀਆਂ ਵਿਰੋਧੀ ਹੇਰਾਫੇਰੀ ਰਾਹੀਂ ਵਿਹਾਰ ਬਦਲਣ ਦੀਆਂ ਕੋਸ਼ਿਸ਼ਾਂ ਵਿਰੁੱਧ ਮਜ਼ਬੂਤ ਹੋਣ।
ਇਹ ਲੋੜ ਕਾਨੂੰਨ ਦੇ ਪਾਠ ਵਿੱਚ ਹੈ। ਕਾਨੂੰਨ ਜਾਣਬੁੱਝ ਕੇ ਤਕਨੀਕੀ ਨਿਯੰਤਰਣ ਦੱਸਣ ਦੀ ਥਾਂ ਲੋੜੀਂਦੇ ਨਤੀਜੇ ਨਿਰਧਾਰਤ ਕਰਦਾ ਹੈ। ਹਰ ਤਾਇਨਾਤੀ ਹਾਲਾਤ ਵਿੱਚ ਵਿਰੋਧੀ ਹਮਲਿਆਂ ਵਿਰੁੱਧ ਮਜ਼ਬੂਤੀ ਸਾਬਤ ਕਰਨ ਦੇ ਤਕਨੀਕੀ ਤਰੀਕਿਆਂ ਬਾਰੇ ਹਾਲੇ ਹਰ ਪ੍ਰਣਾਲੀ ਅਤੇ ਵਰਤੋਂ ਲਈ ਸਹਿਮਤ ਜਵਾਬ ਨਹੀਂ ਹਨ।
EU AI Act ਉੱਤੇ ਆਧਾਰਿਤ ਸਰਟੀਫਿਕੇਸ਼ਨ ਤੁਹਾਨੂੰ AI ਪ੍ਰਣਾਲੀਆਂ ਦੀ ਵਰਗੀਕਰਨ, ਤਕਨੀਕੀ ਦਸਤਾਵੇਜ਼ ਲਿਖਣ ਅਤੇ ਨਿਗਰਾਨੀ ਦੀਆਂ ਪ੍ਰਕਿਰਿਆਵਾਂ ਬਣਾਉਣ ਲਈ ਤਿਆਰ ਕਰਦੇ ਹਨ। ਇਹ audit ਲਈ ਤਿਆਰੀ ਕਰਦੇ ਹਨ। ਕਾਨੂੰਨ ਦੀ ਮਜ਼ਬੂਤੀ ਵਾਲੀ ਸ਼ਰਤ ਪੂਰੀ ਕਰਨ ਵਾਲੀ ਪ੍ਰਣਾਲੀ ਬਣਾਉਣ ਦਾ ਇੰਜੀਨੀਅਰਿੰਗ ਕੰਮ, ਅੱਜ ਦੇ ਸਰਟੀਫਿਕੇਸ਼ਨ ਤੋਂ ਵੱਖਰਾ ਖੇਤਰ ਹੈ।
AI ਪ੍ਰਣਾਲੀਆਂ ਉੱਤੇ ਅਸਲ ਵਿੱਚ ਕਿਹੜੇ ਹਮਲੇ ਹੁੰਦੇ ਹਨ
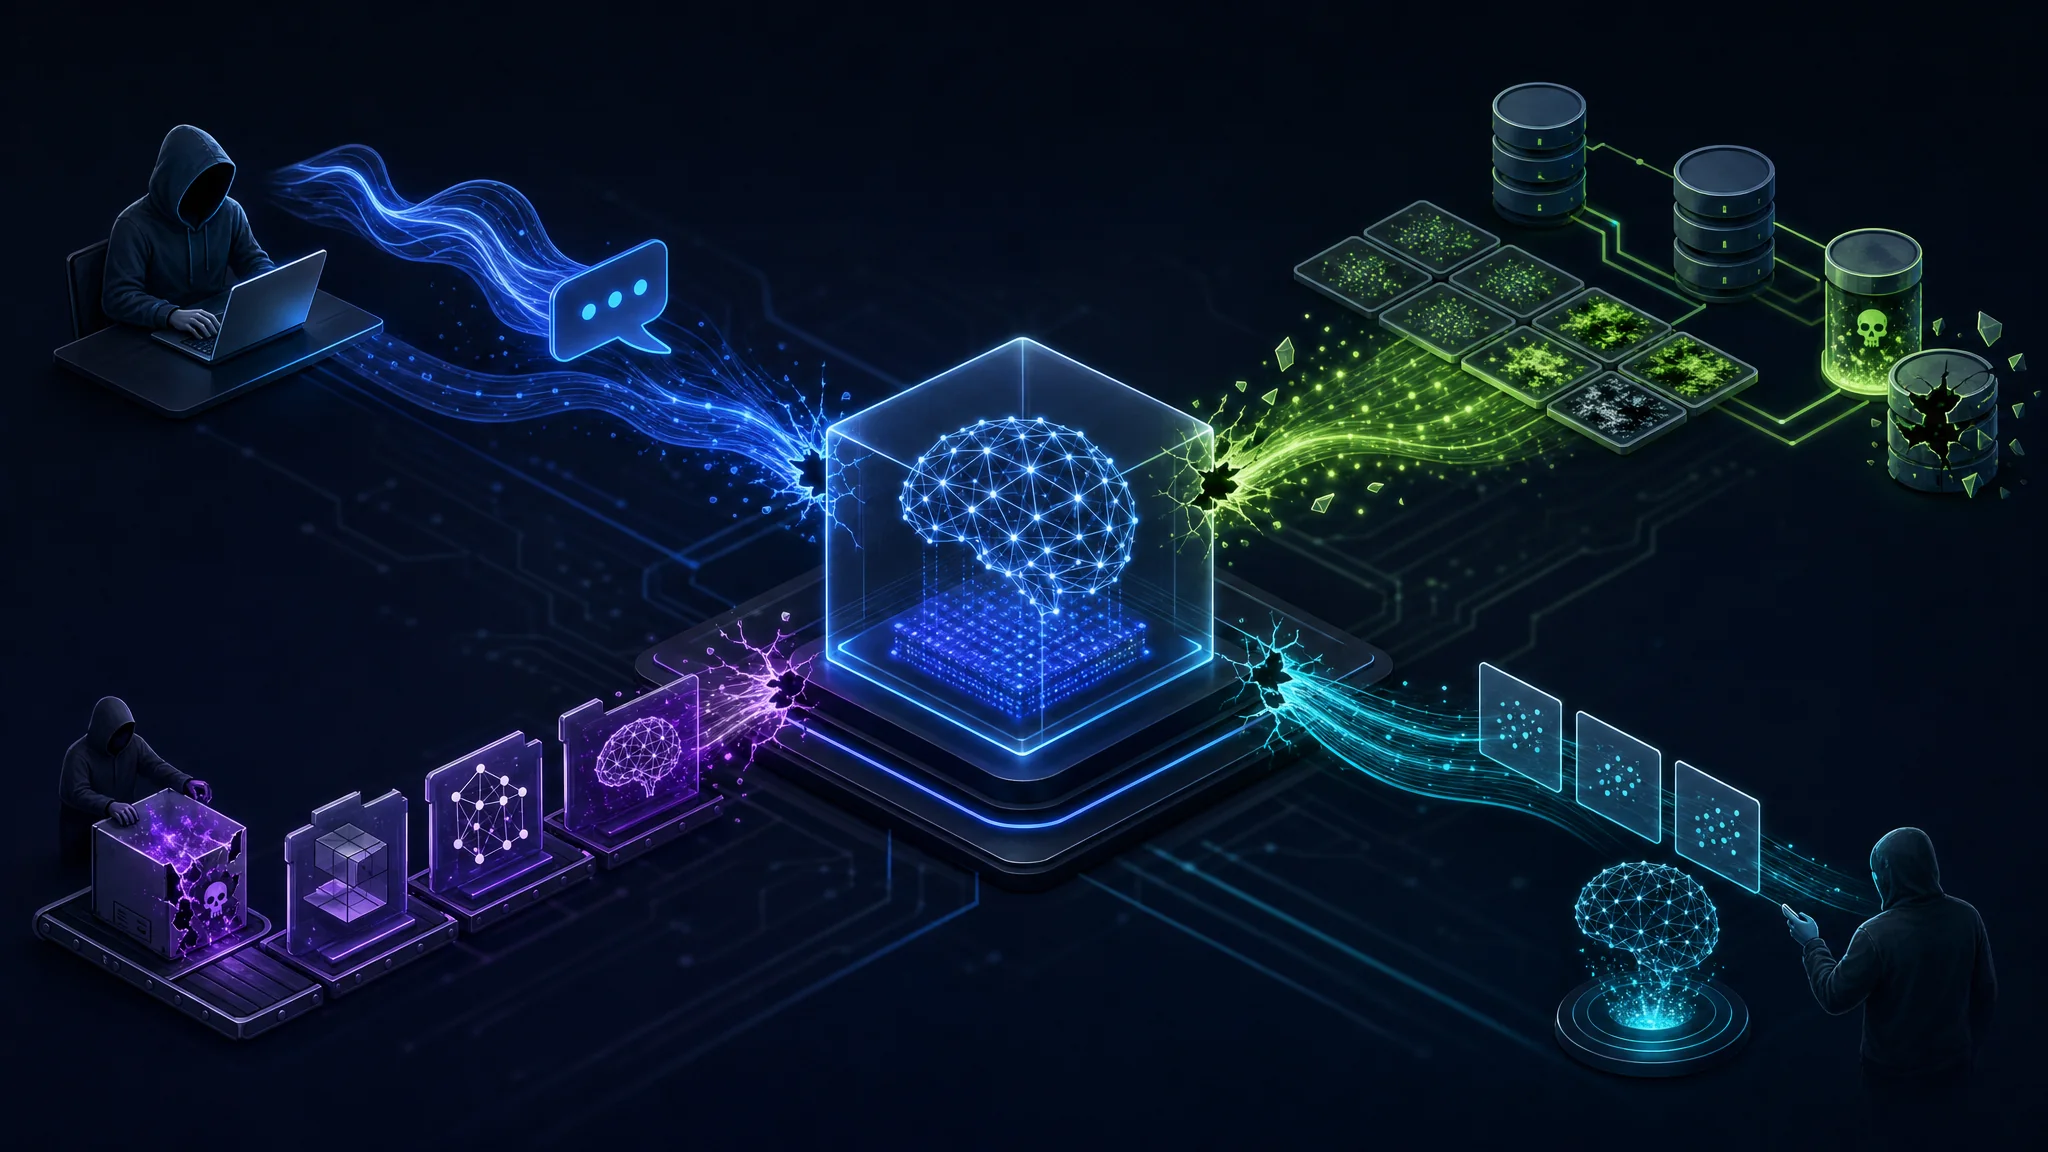
MITRE ATLAS ਅਤੇ OWASP LLM Top 10 ਅਮਲੀ ਖਤਰਾ-ਦ੍ਰਿਸ਼ ਦਾ ਦਸਤਾਵੇਜ਼ ਬਣਾਉਂਦੇ ਹਨ। ਇਹ ਸਰੋਤ ਹਮਲਿਆਂ ਨੂੰ ਲਾਭਦਾਇਕ ਪੱਧਰ ਦੇ ਵੇਰਵੇ ਨਾਲ ਦਰਜ ਕਰਦੇ ਹਨ। ਗਵਰਨੈਂਸ ਢਾਂਚੇ ਖਤਰਿਆਂ ਨੂੰ ਵਧੇਰੇ ਆਮ ਰੂਪ ਵਿੱਚ ਦੱਸਦੇ ਹਨ। ਹੇਠਾਂ ਦਿੱਤੀ ਜਾਣਕਾਰੀ ਇਨ੍ਹਾਂ ਸੁਰੱਖਿਆ-ਵਿਸ਼ੇਸ਼ ਸਰੋਤਾਂ ਤੋਂ ਹੈ।
Prompt injection ਵਿੱਚ language model ਨੂੰ ਅਜਿਹਾ input ਦਿੱਤਾ ਜਾਂਦਾ ਹੈ ਜੋ system instructions ਨੂੰ ਬਦਲਦਾ ਜਾਂ ਉਨ੍ਹਾਂ ਨਾਲ ਹੇਰਾਫੇਰੀ ਕਰਦਾ ਹੈ। ਸਿੱਧਾ injection ਮਾਡਲ ਦੇ input ਨੂੰ ਨਿਸ਼ਾਨਾ ਬਣਾਉਂਦਾ ਹੈ। ਅਸਿੱਧਾ injection, ਮਾਡਲ ਵੱਲੋਂ ਪ੍ਰਾਪਤ, ਸੰਸਾਧਿਤ ਜਾਂ ਸੰਖੇਪ ਕੀਤੀ ਸਮੱਗਰੀ ਵਿੱਚ ਖਤਰਨਾਕ ਹਦਾਇਤਾਂ ਲੁਕਾਉਂਦਾ ਹੈ। ਤੁਹਾਡੀ RAG pipeline ਹਮਲਾਵਰ ਦੇ ਕਾਬੂ ਵਾਲਾ ਦਸਤਾਵੇਜ਼ ਪੜ੍ਹ ਕੇ ਉਸ ਵਿੱਚ ਲੁਕੀਆਂ ਹਦਾਇਤਾਂ ਉੱਤੇ ਕੰਮ ਕਰਦੀ ਹੈ। ਤੁਹਾਡਾ browsing agent ਹਮਲਾਵਰ ਦਾ ਵੈੱਬਪੰਨਾ ਖੋਲ੍ਹ ਕੇ ਉਸ ਵਿੱਚ ਦਿੱਤੀਆਂ ਹਦਾਇਤਾਂ ਮੰਨ ਲੈਂਦਾ ਹੈ। ਤੁਹਾਡਾ customer support bot ਅਜਿਹਾ ਲੇਖ ਸੰਖੇਪ ਕਰਦਾ ਹੈ ਜਿਸ ਵਿੱਚ ਸੁਰੱਖਿਆ ਨਿਯਮਾਂ ਨੂੰ ਅਣਡਿੱਠਾ ਕਰਨ ਲਈ ਕਿਹਾ ਗਿਆ ਹੋਵੇ।
2026 ਤੱਕ prompt injection ਲਈ ਹਰ ਹਾਲਤ ਵਿੱਚ ਕੰਮ ਕਰਨ ਵਾਲਾ ਕੋਈ ਰੋਕਥਾਮ ਤਰੀਕਾ ਨਹੀਂ ਹੈ। ਬਹੁ-ਪਰਤੀ ਬਚਾਅ ਜੋਖਮ ਘਟਾਉਂਦਾ ਹੈ: input filtering, output validation, ਸੀਮਤ ਅਧਿਕਾਰਾਂ ਵਾਲੇ tool scopes, sandbox ਵਾਲੇ execution ਵਾਤਾਵਰਣ ਅਤੇ ਮਹੱਤਵਪੂਰਨ ਕਾਰਵਾਈਆਂ ਲਈ ਮਨੁੱਖੀ ਮਨਜ਼ੂਰੀ। ਇਨ੍ਹਾਂ ਵਿੱਚੋਂ ਕੋਈ ਵੀ ਹਮਲੇ ਦੀ ਕਿਸਮ ਨੂੰ ਪੂਰੀ ਤਰ੍ਹਾਂ ਨਹੀਂ ਮਿਟਾਉਂਦਾ। NIST, OWASP, Anthropic, OpenAI, Google ਅਤੇ Microsoft ਇੱਕੋ ਹੱਲ ਦੀ ਥਾਂ ਕਈ ਪਰਤੀ ਨਿਯੰਤਰਣ ਦੀ ਸਿਫ਼ਾਰਸ਼ ਕਰਦੇ ਹਨ।
Training data poisoning ਵਿੱਚ training data ਅੰਦਰ ਖਤਰਨਾਕ ਉਦਾਹਰਨਾਂ ਪਾਈਆਂ ਜਾਂਦੀਆਂ ਹਨ ਤਾਂ ਜੋ ਮਾਡਲ ਦਾ ਵਿਹਾਰ ਖ਼ਰਾਬ ਹੋਵੇ, backdoors ਆਉਣ ਜਾਂ trigger ਅਧਾਰਿਤ ਵਿਹਾਰ ਸਥਾਪਤ ਹੋਵੇ। ਸਫਲ poisoning ਦਾ ਸੰਕੇਤ ਅਕਸਰ ਉਦੋਂ ਤੱਕ ਨਹੀਂ ਦਿਸਦਾ ਜਦ ਤੱਕ ਮਾਡਲ ਖਾਸ trigger input ਨਾ ਵੇਖੇ। ਜੇ ਤੁਹਾਡਾ ਸੰਗਠਨ user-generated content, ਪ੍ਰਾਪਤ ਦਸਤਾਵੇਜ਼ ਜਾਂ ਤੀਜੀ ਧਿਰ ਦੇ datasets ਤੋਂ ਮਾਡਲ fine-tune ਕਰਦਾ ਹੈ ਅਤੇ ਉਨ੍ਹਾਂ ਦਾ ਮੂਲ ਨਹੀਂ ਜਾਂਚਦਾ, ਤਾਂ ਇਹ ਜੋਖਮ ਤੁਹਾਡੇ ਲਈ ਹੈ।
Model supply chain compromise ਉਹ ਖਤਰਾ ਹੈ ਜਿਸ ਨੂੰ ਜ਼ਿਆਦਾਤਰ ਸੰਗਠਨ ਬਾਅਦ ਦੀ ਗੱਲ ਸਮਝਦੇ ਹਨ। Model repositories ਅਕਸਰ model weights ਨਾਲ ਚਲਾਉਣਯੋਗ code ਵੀ ਵੰਡਦੇ ਹਨ। pickle ਵਰਗੇ ਅਸੁਰੱਖਿਅਤ serialization formats ਵਾਰ-ਵਾਰ supply-chain ਜੋਖਮ ਬਣੇ ਹਨ। ਮਾਡਲ download ਨਾਲ ਆਉਣ ਵਾਲੇ packages ਆਪਣੀਆਂ ਕਮਜ਼ੋਰੀਆਂ ਵਾਲੀਆਂ dependencies ਲਗਾ ਸਕਦੇ ਹਨ। ਜਨਤਕ repositories ਤੋਂ ਮਾਡਲ ਲੈਣ ਵੇਲੇ ਕਈ ਸੰਗਠਨ, software dependencies ਨਾਲੋਂ ਕਾਫ਼ੀ ਘੱਟ supply-chain ਜਾਂਚ ਕਰਦੇ ਦਿਸਦੇ ਹਨ। ਹਮਲਾ-ਸਤਹ npm ਨਾਲ ਮਿਲਦੀ ਹੈ, ਪਰ ਇਸ ਦੇ ਆਲੇ-ਦੁਆਲੇ ਸੁਰੱਖਿਆ ਸੰਸਕ੍ਰਿਤੀ ਹਾਲੇ ਕਾਫ਼ੀ ਨਵੀਂ ਹੈ।
Model extraction ਵਿੱਚ ਹਮਲਾਵਰ ਤੁਹਾਡੇ API ਨੂੰ ਵਾਰ-ਵਾਰ inference queries ਭੇਜ ਕੇ ਕਾਰਜਕਾਰੀ ਤੌਰ ਉੱਤੇ ਮਿਲਦੇ-ਜੁਲਦੇ ਮਾਡਲ ਮੁੜ ਬਣਾਉਂਦੇ ਹਨ। ਇਸ ਨਾਲ ਬੌਧਿਕ ਸੰਪਤੀ ਦਾ ਨੁਕਸਾਨ ਹੁੰਦਾ ਹੈ ਅਤੇ ਤੁਹਾਡੇ ਮਾਡਲ ਦਾ offline ਅਧਿਐਨ ਕਰਕੇ ਹੋਰ ਨਿਸ਼ਾਨੇਵੰਦ ਹਮਲੇ ਬਣਾਉਣ ਦਾ ਮੌਕਾ ਮਿਲਦਾ ਹੈ।
Membership inference ਨਾਲ ਹਮਲਾਵਰ ਵੱਖਰੇ ਭਰੋਸੇ ਪੱਧਰਾਂ ਉੱਤੇ ਪਤਾ ਕਰ ਸਕਦੇ ਹਨ ਕਿ ਖਾਸ ਡਾਟਾ ਰਿਕਾਰਡ training set ਵਿੱਚ ਸੀ ਜਾਂ ਨਹੀਂ। ਇਹ ਮਾਡਲ ਦੀ ਬਣਤਰ ਅਤੇ training ਤਰੀਕੇ ਉੱਤੇ ਨਿਰਭਰ ਕਰਦਾ ਹੈ। ਨਿੱਜੀ ਜਾਣਕਾਰੀ ਨਾਲ training ਕਰਨ ਵਾਲੇ ਸੰਗਠਨਾਂ ਲਈ ਇਸ ਨਾਲ ਗੋਪਨੀਯਤਾ ਦਾ ਜੋਖਮ ਬਣਦਾ ਹੈ।
Adversarial inputs, ਸੋਚ-ਸਮਝ ਕੇ ਬਣਾਏ ਬਦਲਾਅ ਰਾਹੀਂ ਮਾਡਲ ਦੇ ਨਤੀਜੇ ਬਦਲਦੇ ਹਨ। ਇਸ ਤਰੀਕੇ ਉੱਤੇ ਸਭ ਤੋਂ ਵੱਧ ਖੋਜ image classification ਵਿੱਚ ਹੋਈ ਹੈ, ਪਰ ਇਹ text, audio ਅਤੇ multimodal ਪ੍ਰਣਾਲੀਆਂ ਉੱਤੇ ਵੀ ਲਾਗੂ ਹੁੰਦਾ ਹੈ। ਜੇ ਤੁਹਾਡਾ AI ਧੋਖਾਧੜੀ ਦੀ ਪਛਾਣ, ਕਰਜ਼-ਯੋਗਤਾ, ਮੈਡੀਕਲ ਤਸਵੀਰਾਂ ਜਾਂ ਭੌਤਿਕ ਪਹੁੰਚ ਬਾਰੇ ਫੈਸਲੇ ਕਰਦਾ ਹੈ, ਤਾਂ ਵਿਰੋਧੀ ਹਮਲਿਆਂ ਵਿਰੁੱਧ ਮਜ਼ਬੂਤੀ ਸੁਰੱਖਿਆ ਗੁਣ ਹੈ ਜਿਸ ਦੀ ਜਾਂਚ ਕਰਨੀ ਚਾਹੀਦੀ ਹੈ, ਸਿਰਫ਼ ਦਸਤਾਵੇਜ਼ ਨਹੀਂ ਬਣਾਉਣਾ।
AI ਪ੍ਰਣਾਲੀਆਂ ਰਾਹੀਂ ਡਾਟਾ ਲੀਕ ਹੋਣ ਵੱਲ ਸਿੱਧਾ ਧਿਆਨ ਚਾਹੀਦਾ ਹੈ। RAG pipelines ਤੁਹਾਡੇ knowledge base ਦੇ ਦਸਤਾਵੇਜ਼ ਕਦੇ-ਕਦੇ ਅਜਿਹੇ ਉਪਭੋਗਤਾਵਾਂ ਨੂੰ ਦਿਖਾਉਂਦੀਆਂ ਹਨ ਜਿਨ੍ਹਾਂ ਨੂੰ ਪਹੁੰਚ ਨਹੀਂ ਹੋਣੀ ਚਾਹੀਦੀ। System instructions ਤੋਂ prompt leakage, ਉਹ ਅੰਦਰੂਨੀ ਵੇਰਵੇ ਦੱਸ ਸਕਦੀ ਹੈ ਜਿਨ੍ਹਾਂ ਨੂੰ ਗੁਪਤ ਰੱਖਣਾ ਸੀ। Multi-tenant AI ਤਾਇਨਾਤੀ ਵਿੱਚ ਅਲੱਗਾਵ ਦੀਆਂ ਲੋੜਾਂ ਹੁੰਦੀਆਂ ਹਨ ਜਿਨ੍ਹਾਂ ਨੂੰ ਰਵਾਇਤੀ application security ਇੰਜੀਨੀਅਰ ਕਦੇ-ਕਦੇ ਘੱਟ ਅੰਕਦੇ ਹਨ। ਇਹ ਤਾਇਨਾਤ ਪ੍ਰਣਾਲੀਆਂ ਵਿੱਚ ਨਿਯਮਿਤ ਦਿਸਣ ਵਾਲੇ ਅਮਲੀ ਜੋਖਮ ਹਨ।
AI agents ਹਮਲਾ-ਸਤਹ ਨੂੰ ਪੂਰੀ ਤਰ੍ਹਾਂ ਬਦਲਦੇ ਹਨ
ਜ਼ਿਆਦਾਤਰ AI ਸੁਰੱਖਿਆ ਸਰਟੀਫਿਕੇਸ਼ਨ ਉਸ ਸਮੇਂ ਲਿਖੇ ਗਏ ਜਦੋਂ AI ਪ੍ਰਣਾਲੀਆਂ ਦਾ ਮਤਲਬ ਮੁੱਖ ਤੌਰ ਉੱਤੇ chatbots ਅਤੇ classifiers ਸੀ। 2026 ਵਿੱਚ ਸੰਗਠਨਾਂ ਦਾ AI ਵਧੇਰੇ agents ਉੱਤੇ ਨਿਰਭਰ ਕਰਦਾ ਹੈ।
Agents, chatbots ਤੋਂ ਇੱਕ ਅਮਲੀ ਤੌਰ ਉੱਤੇ ਮਹੱਤਵਪੂਰਨ ਗੱਲ ਨਾਲ ਵੱਖਰੇ ਹਨ: ਉਹ ਕਾਰਵਾਈ ਕਰਦੇ ਹਨ। Email ਪ੍ਰਣਾਲੀ, ਅੰਦਰੂਨੀ databases, file systems, browser ਅਤੇ code execution ਤੱਕ tool ਪਹੁੰਚ ਵਾਲਾ agent, ਹੋਰ ਵਿਸ਼ੇਸ਼ਤਾਵਾਂ ਵਾਲਾ chatbot ਨਹੀਂ। ਉਹ language model ਦੇ ਨਤੀਜਿਆਂ ਮੁਤਾਬਕ ਅਸਲ ਪ੍ਰਣਾਲੀਆਂ ਵਿੱਚ ਵੱਡੀ ਪਹੁੰਚ ਰੱਖਣ ਵਾਲੀ ਖੁਦਮੁਖਤਿਆਰ ਪ੍ਰਕਿਰਿਆ ਹੈ।
OWASP ਹੁਣ ਵੱਖਰਾ Agentic AI Top 10 ਰੱਖਦਾ ਹੈ, ਕਿਉਂਕਿ agents ਦਾ threat model, LLM chat applications ਤੋਂ ਇੰਨਾ ਵੱਖਰਾ ਹੈ ਕਿ ਵੱਖਰੇ ਦਸਤਾਵੇਜ਼ ਲੋੜੀਂਦੇ ਹਨ।
Agent ਵਿੱਚ prompt injection ਨਾਲ ਅਣਚਾਹਿਆ text ਜਵਾਬ ਨਹੀਂ, ਅਣਚਾਹੀ ਕਾਰਵਾਈ ਹੁੰਦੀ ਹੈ। ਪ੍ਰਾਪਤ ਦਸਤਾਵੇਜ਼ ਵਿੱਚ ਅਸਿੱਧਾ injection agent ਨੂੰ ਫਾਈਲਾਂ ਮਿਟਾਉਣ, ਡਾਟਾ ਬਾਹਰ ਭੇਜਣ ਜਾਂ email ਭੇਜਣ ਲਈ ਕਹਿ ਸਕਦਾ ਹੈ। ਨਤੀਜਾ ਅਣਉਚਿਤ ਜਵਾਬ ਨਹੀਂ ਹੁੰਦਾ। ਨਤੀਜਾ ਉਨ੍ਹਾਂ ਪ੍ਰਣਾਲੀਆਂ ਉੱਤੇ ਬਿਨਾਂ ਅਧਿਕਾਰ ਕੀਤੀ ਕਾਰਵਾਈ ਹੁੰਦੀ ਹੈ ਜਿਨ੍ਹਾਂ ਤੱਕ agent ਦੀ ਪਹੁੰਚ ਹੈ।
Agents ਦੀ ਹਮਲਾ-ਸਤਹ ਵਿੱਚ ਇਹ ਗੱਲਾਂ ਆਉਂਦੀਆਂ ਹਨ:
- Tool invocation limits: ਕੀ agent ਹਰ ਕੰਮ ਲਈ ਲੋੜੀਂਦੇ ਘੱਟੋ-ਘੱਟ tools ਤੱਕ ਸੀਮਤ ਹੈ
- Credential scope: ਕੀ agent ਦੇ credentials ਹਰ ਕੰਮ ਲਈ ਲੋੜੀਂਦੀ ਪਹੁੰਚ ਤੱਕ ਸੀਮਤ ਹਨ
- Action reversibility: ਕੀ ਮਹੱਤਵਪੂਰਨ ਕਾਰਵਾਈ ਤੋਂ ਪਹਿਲਾਂ ਮਨੁੱਖੀ ਮਨਜ਼ੂਰੀ ਲੋੜੀਂਦੀ ਹੈ
- Output filtering: ਕੀ agent ਦੇ ਨਤੀਜੇ ਅਗਲੀਆਂ ਕਾਰਵਾਈਆਂ ਚਲਾਉਣ ਤੋਂ ਪਹਿਲਾਂ ਜਾਂਚੇ ਜਾਂਦੇ ਹਨ
- Sandboxing: ਕੀ agent ਦਾ execution ਵਾਤਾਵਰਣ ਜੁੜੀਆਂ ਪ੍ਰਣਾਲੀਆਂ ਤੱਕ ਅਣਚਾਹੀ ਪਹੁੰਚ ਰੋਕਦਾ ਹੈ
ਜ਼ਿਆਦਾਤਰ AI ਗਵਰਨੈਂਸ ਸਰਟੀਫਿਕੇਸ਼ਨ ਇਸ ਖਾਸ ਪੱਧਰ ਉੱਤੇ agent ਸੁਰੱਖਿਆ ਡਿਜ਼ਾਇਨ ਨਹੀਂ ਕਵਰ ਕਰਦੇ।
Model Context Protocol ਨਵੀਂ enterprise ਹਮਲਾ-ਸਤਹ ਬਣਾਉਂਦਾ ਹੈ
Model Context Protocol (MCP), AI agents ਨੂੰ ਬਾਹਰੀ tools, ਡਾਟਾ ਸਰੋਤਾਂ ਅਤੇ ਸੇਵਾਵਾਂ ਨਾਲ ਜੋੜਨ ਲਈ ਵਿਆਪਕ ਤੌਰ ਉੱਤੇ ਅਪਣਾਇਆ ਗਿਆ ਮਿਆਰ ਬਣ ਗਿਆ ਹੈ। MCP servers ਉਹ ਸਮਰੱਥਾਵਾਂ ਦਿਖਾਉਂਦੇ ਹਨ ਜਿਨ੍ਹਾਂ ਨੂੰ agents ਲੱਭ ਕੇ ਵਰਤਦੇ ਹਨ। ਇਹ ਜੋੜ ਤੇਜ਼ ਅਤੇ ਲਚਕੀਲਾ ਹੈ। ਸੁਰੱਖਿਆ ਪ੍ਰਭਾਵਾਂ ਨੂੰ ਹਮੇਸ਼ਾ ਬਰਾਬਰ ਧਿਆਨ ਨਹੀਂ ਮਿਲਦਾ।
MCP ਨਾਲ ਜੁੜੇ ਜੋਖਮਾਂ ਵਿੱਚ ਇਹ ਸ਼ਾਮਲ ਹਨ:
- ਖਤਰਨਾਕ MCP servers, ਜੋ agent ਨੂੰ ਆਪਣੀਆਂ ਸਮਰੱਥਾਵਾਂ ਬਾਰੇ ਗਲਤ ਦੱਸ ਕੇ ਅਣਚਾਹੀਆਂ ਕਾਰਵਾਈਆਂ ਕਰਦੇ ਹਨ
- Tool poisoning, ਜਿਸ ਵਿੱਚ ਜਾਇਜ਼ MCP server ਹਮਲਾਵਰ ਦਾ ਕਾਬੂ ਵਾਲਾ ਡਾਟਾ ਵਾਪਸ ਕਰਦਾ ਹੈ ਅਤੇ ਡਾਟਾ output ਵਿੱਚ ਹਦਾਇਤਾਂ ਸ਼ਾਮਲ ਹੁੰਦੀਆਂ ਹਨ
- ਵੱਧ ਅਧਿਕਾਰ ਵਾਲੇ tools, ਜਿਨ੍ਹਾਂ ਦੇ MCP integrations ਕੋਲ ਕੰਮ ਦੀ ਲੋੜ ਨਾਲੋਂ ਵੱਧ ਪਹੁੰਚ ਹੁੰਦੀ ਹੈ
- Trust boundary ਦੀ ਗਡ਼ਬਡ਼, ਜਿੱਥੇ agent ਨਾਲ ਜੁੜੇ MCP tools ਦੀਆਂ ਹਦਾਇਤਾਂ ਉਪਭੋਗਤਾ ਦੀਆਂ ਹਦਾਇਤਾਂ ਵਰਗੀਆਂ ਲੱਗਦੀਆਂ ਹਨ
MCP integrations ਵਾਲੇ agents ਤਾਇਨਾਤ ਕਰਨ ਵਾਲੇ ਸੰਗਠਨਾਂ ਨੂੰ MCP server ਦੇ ਭਰੋਸੇ ਦਾ ਮੁਲਾਂਕਣ ਕਰਨ, tool permissions ਦੀ ਜਾਂਚ ਕਰਨ ਅਤੇ tool responses ਨੂੰ ਹਦਾਇਤਾਂ ਦੀ ਥਾਂ ਡਾਟਾ ਮੰਨਣ ਦੀ ਤਸਦੀਕ ਲਈ ਢਾਂਚਾ ਚਾਹੀਦਾ ਹੈ।
ਮੁਲਾਂਕਣ ਉਹ ਅਮਲੀ ਕੰਮ ਹੈ ਜੋ ਸਰਟੀਫਿਕੇਸ਼ਨ ਛੱਡਦੇ ਹਨ
ਤਾਇਨਾਤੀ ਤੋਂ ਪਹਿਲਾਂ ਅਤੇ ਬਾਅਦ AI ਮਾਡਲ ਜੋਖਮ ਸਮਝਣ ਲਈ, AI red teaming ਅਤੇ evaluation suites ਰਵਾਇਤੀ ਸੁਰੱਖਿਆ ਮੁਲਾਂਕਣਾਂ ਦੀ ਥਾਂ ਲੈ ਰਹੇ ਹਨ।
AI red teaming ਵਿੱਚ ਇਹ ਸ਼ਾਮਲ ਹੈ:
- ਜਾਣੀਆਂ ਹਮਲਾ ਤਕਨੀਕਾਂ ਵਿਰੁੱਧ ਮਾਡਲ ਵਿਹਾਰ ਦੀ ਯੋਜਨਾਬੱਧ ਵਿਰੋਧੀ ਜਾਂਚ
- ਸਥਾਪਤ prompt attack datasets ਨਾਲ jailbreak benchmarking
- ਬਦਲੇ inputs ਕਾਰਨ output ਵਿੱਚ ਤਬਦੀਲੀ ਮਾਪਣ ਵਾਲੀ adversarial robustness ਜਾਂਚ
- ਮਾਡਲ versions ਵਿਚਕਾਰ ਵਿਹਾਰਕ regression testing
- ਪ੍ਰਕਾਸ਼ਿਤ evaluation suites ਵਿਰੁੱਧ safety benchmark ਮੁਲਾਂਕਣ
NIST, Anthropic, OpenAI, Microsoft, Google ਅਤੇ CISA ਉੱਚ-ਜੋਖਮ ਪ੍ਰਣਾਲੀਆਂ ਤਾਇਨਾਤ ਕਰਨ ਤੋਂ ਪਹਿਲਾਂ AI-ਵਿਸ਼ੇਸ਼ red teaming ਦੀ ਸਿਫ਼ਾਰਸ਼ ਕਰਦੇ ਹਨ। ਇਹ ਵਿਕਲਪੀ ਅਮਲ ਦੀ ਥਾਂ ਮਿਆਰੀ ਉਮੀਦ ਬਣ ਰਿਹਾ ਹੈ।
ਮੌਜੂਦਾ AI ਗਵਰਨੈਂਸ ਸਰਟੀਫਿਕੇਸ਼ਨਾਂ ਵਿੱਚੋਂ ਕੋਈ ਵੀ ਅਭਿਆਸੀਆਂ ਨੂੰ ਤਾਇਨਾਤ ਮਾਡਲ ਜਾਂ agent ਉੱਤੇ red teaming ਦੀ ਹੱਦ ਤੈਅ ਕਰਨ, ਇਸ ਨੂੰ ਚਲਾਉਣ ਜਾਂ ਨਤੀਜੇ ਸਮਝਣ ਲਈ ਪੂਰੀ ਤਿਆਰੀ ਨਹੀਂ ਦਿੰਦਾ। ਇਹ ਦੱਸਦੇ ਹਨ ਕਿ red teaming ਕੀ ਹੈ। ਇਹ ਕਰਨਾ ਨਹੀਂ ਸਿਖਾਉਂਦੇ।
AI observability ਵੱਖਰਾ ਖੇਤਰ ਹੈ
ਰਵਾਇਤੀ ਸੁਰੱਖਿਆ logging ਨੂੰ ਸਿੱਧਾ AI ਪ੍ਰਣਾਲੀਆਂ ਉੱਤੇ ਲਾਗੂ ਨਹੀਂ ਕੀਤਾ ਜਾ ਸਕਦਾ। ਉਤਪਾਦਨ ਵਿੱਚ LLM ਜਾਂ agent ਦੀ ਨਿਗਰਾਨੀ ਲਈ ਵੱਖਰਾ ਡਾਟਾ ਇਕੱਠਾ ਕਰਨਾ ਅਤੇ ਵੱਖਰਾ ਵਿਸ਼ਲੇਸ਼ਣ ਲੋੜੀਂਦਾ ਹੈ।
AI observability ਢਾਂਚੇ ਵਿੱਚ ਇਹ ਸ਼ਾਮਲ ਹੈ:
- ਅਸਧਾਰਨਤਾ ਲੱਭਣ ਅਤੇ ਨੀਤੀ ਉਲੰਘਣਾ ਪਛਾਣਣ ਲਈ prompt ਅਤੇ output telemetry
- agents ਲਈ tool invocation logs, ਜਿਨ੍ਹਾਂ ਵਿੱਚ ਦਰਜ ਹੋਵੇ ਕਿ ਕਿਹੜੇ arguments ਨਾਲ ਕਿਹੜੇ tools ਚਲਾਏ ਗਏ
- RAG pipelines ਲਈ retrieval ਗੁਣਵੱਤਾ ਦੀ ਨਿਗਰਾਨੀ
- jailbreak ਕੋਸ਼ਿਸ਼ਾਂ ਦੀ ਪਛਾਣ ਅਤੇ ਵਰਗੀਕਰਨ
- versions ਵਿਚਕਾਰ model drift ਲੱਭਣ ਲਈ output consistency ਦੀ ਨਿਗਰਾਨੀ
- ਤੱਥਕ ਸਹੀਪਣ ਮਹੱਤਵਪੂਰਨ ਹੋਣ ਵਾਲੀਆਂ applications ਲਈ hallucination ਦਰ ਦੀ ਨਿਗਰਾਨੀ
- latency ਦੇ ਅਜਿਹੇ ਰੁਝਾਨ ਜੋ prompt injection ਕਾਰਨ context ਦਾ ਆਕਾਰ ਵਧਣ ਦਾ ਸੰਕੇਤ ਦੇ ਸਕਦੇ ਹਨ
ਇਹ ਉੱਭਰਦਾ ਹੋਇਆ ਖੇਤਰ ਹੈ। 2026 ਵਿੱਚ AI ਤਾਇਨਾਤ ਕਰਨ ਵਾਲੇ ਜ਼ਿਆਦਾਤਰ ਸੰਗਠਨਾਂ ਨੂੰ ਆਪਣੀ ਰਵਾਇਤੀ ਢਾਂਚਾਗਤ ਪ੍ਰਣਾਲੀ ਨਾਲੋਂ AI ਹਿੱਸਿਆਂ ਬਾਰੇ ਕਾਫ਼ੀ ਘੱਟ ਦਿੱਖ ਮਿਲਦੀ ਹੈ। ਜ਼ਿਆਦਾਤਰ ਗਵਰਨੈਂਸ ਸਰਟੀਫਿਕੇਸ਼ਨ ਇਹ ਨਹੀਂ ਦੱਸਦੇ ਕਿ AI ਲਈ ਢੁੱਕਵੀਂ observability ਕਿਹੋ ਜਿਹੀ ਹੋਣੀ ਚਾਹੀਦੀ ਹੈ।
AI incident response ਆਮ IR ਵਰਗੀ ਨਹੀਂ
ਰਵਾਇਤੀ ਪ੍ਰਣਾਲੀ ਨਾਲ ਸਮਝੌਤਾ ਹੋਣ ਉੱਤੇ ਤੁਹਾਡਾ IR playbook ਰੋਕਥਾਮ, forensics ਅਤੇ ਮੁੜ-ਬਹਾਲੀ ਦੱਸਦਾ ਹੈ। AI incidents ਅਜਿਹੇ ਸਵਾਲ ਲਿਆਉਂਦੇ ਹਨ ਜਿਨ੍ਹਾਂ ਦੇ ਜਵਾਬ ਮਿਆਰੀ playbook ਵਿੱਚ ਨਹੀਂ ਹਨ।
ਲੋੜ ਪੈਣ ਤੋਂ ਪਹਿਲਾਂ ਤੁਹਾਡੇ playbooks ਵਿੱਚ ਇਹ ਸਵਾਲ ਹੋਣੇ ਚਾਹੀਦੇ ਹਨ:
- Fine-tuning ਦੌਰਾਨ ਮਾਡਲ ਨੂੰ poison ਕੀਤਾ ਗਿਆ ਸੀ ਜਾਂ ਨਹੀਂ, ਇਹ ਕਿਵੇਂ ਪਤਾ ਕਰਨਾ ਹੈ
- RAG retrieval ਦੀ ਦੁਰਵਰਤੋਂ ਕਰਕੇ ਹਮਲਾਵਰ ਦੇ ਕਾਬੂ ਵਾਲੀ ਸਮੱਗਰੀ ਵਾਪਸ ਕੀਤੀ ਗਈ ਸੀ ਜਾਂ ਨਹੀਂ, ਇਹ ਕਿਵੇਂ ਜਾਂਚਣਾ ਹੈ
- Agent ਨੇ ਬਿਨਾਂ ਅਧਿਕਾਰ ਕਿਹੜੀਆਂ ਕਾਰਵਾਈਆਂ ਕੀਤੀਆਂ ਅਤੇ ਉਨ੍ਹਾਂ ਦਾ ਦਾਇਰਾ ਕੀ ਸੀ, ਇਹ ਕਿਵੇਂ ਪਛਾਣਨਾ ਹੈ
- ਤੀਜੀ ਧਿਰ ਦੇ provider ਦੇ model update ਨੇ ਸੁਰੱਖਿਆ ਲਈ ਮਹੱਤਵਪੂਰਨ ਵਿਹਾਰ ਬਦਲਿਆ ਸੀ ਜਾਂ ਨਹੀਂ, ਇਹ ਕਿਵੇਂ ਤਸਦੀਕ ਕਰਨਾ ਹੈ
- ਘਟਨਾ ਤੋਂ ਪਹਿਲਾਂ ਮਾਡਲ ਦਾ ਵਿਹਾਰ ਕੀ ਸੀ ਤਾਂ ਜੋ ਘਟਨਾ ਤੋਂ ਬਾਅਦ ਨਾਲ ਤੁਲਨਾ ਹੋਵੇ, ਇਹ ਕਿਵੇਂ ਦਰਜ ਕਰਨਾ ਹੈ
ਇਨ੍ਹਾਂ ਲਈ ਘਟਨਾ ਤੋਂ ਪਹਿਲਾਂ ਤਿਆਰੀ ਚਾਹੀਦੀ ਹੈ। ਇਨ੍ਹਾਂ ਲਈ logs ਅਤੇ telemetry ਪਹਿਲਾਂ ਤੋਂ ਲਗਾਉਣੇ ਪੈਂਦੇ ਹਨ। ਇਨ੍ਹਾਂ ਲਈ AI-ਵਿਸ਼ੇਸ਼ runbooks ਚਾਹੀਦੇ ਹਨ ਜੋ ਸਿਰਫ਼ network traffic ਅਤੇ endpoint logs ਨਹੀਂ, ਮਾਡਲ ਦੇ ਵਿਹਾਰ ਦੀ ਜਾਂਚ ਨੂੰ ਵੀ ਥਾਂ ਦੇਣ।
ਸਰਟੀਫਿਕੇਸ਼ਨ ਅੱਪਡੇਟ ਕਰਨ ਦੀ ਸਮੱਸਿਆ
ਸਰਟੀਫਿਕੇਸ਼ਨ ਮੌਜੂਦਾ ਅਮਲ ਤੋਂ ਪਿੱਛੇ ਰਹਿਣ ਦਾ ਇੱਕ ਢਾਂਚਾਗਤ ਕਾਰਨ ਹੈ: AI ਸੁਰੱਖਿਆ ਸਰਟੀਫਿਕੇਸ਼ਨ ਅੱਪਡੇਟ ਚੱਕਰਾਂ ਨਾਲੋਂ ਤੇਜ਼ੀ ਨਾਲ ਬਦਲਦੀ ਹੈ।
Security+, CISSP ਅਤੇ ISO 27001 ਕਈ ਸਾਲਾਂ ਵਿੱਚ ਬਦਲਦੇ ਖੇਤਰ ਕਵਰ ਕਰਦੇ ਹਨ। Networks, endpoints ਅਤੇ applications ਦੀਆਂ ਮੁੱਢਲੀਆਂ ਹਮਲਾ-ਸਤਹਾਂ ਤੁਲਨਾਤਮਕ ਤੌਰ ਉੱਤੇ ਸਥਿਰ ਹਨ। AI ਹਮਲਾ ਤਕਨੀਕਾਂ ਮਹੀਨਿਆਂ ਵਿੱਚ ਬਦਲਦੀਆਂ ਹਨ। 2026 ਦੀਆਂ prompt injection ਤਕਨੀਕਾਂ, ਵਿਰੋਧੀ ਹਮਲੇ ਦੇ ਤਰੀਕੇ ਅਤੇ agentic ਹਮਲਾ-ਸਤਹਾਂ 2023 ਅਤੇ 2024 ਵਿੱਚ ਪਹਿਲੇ AI ਸਰਟੀਫਿਕੇਸ਼ਨ ਸ਼ੁਰੂ ਹੋਣ ਸਮੇਂ ਵਾਲੀਆਂ ਤਕਨੀਕਾਂ ਤੋਂ ਵੱਖ ਹਨ।
ਸਰਟੀਫਿਕੇਸ਼ਨ ਸੰਸਥਾਵਾਂ ਨਿਰਧਾਰਤ ਸਮੇਂ ਅਨੁਸਾਰ ਸਮੱਗਰੀ ਅੱਪਡੇਟ ਕਰਦੀਆਂ ਹਨ। OWASP LLM Top 10 ਨੇ ਪਹਿਲੇ ਸਾਲ ਵਿੱਚ ਹੀ ਵੱਡਾ ਸੋਧਿਆ ਸੰਸਕਰਣ ਜਾਰੀ ਕੀਤਾ। ਕਈ ਮੌਜੂਦਾ AI ਸਰਟੀਫਿਕੇਸ਼ਨ ਬਣਦੇ ਸਮੇਂ MCP enterprise ਚਿੰਤਾ ਨਹੀਂ ਸੀ। Agentic AI ਸੁਰੱਖਿਆ ਢਾਂਚੇ ਮੌਜੂਦਾ ਸਰਟੀਫਿਕੇਸ਼ਨ ਪਾਠਕ੍ਰਮਾਂ ਤੋਂ ਬਾਅਦ ਆਏ।
ਇਹ ਢਾਂਚਾਗਤ ਸਮੱਸਿਆ ਹੈ, ਇਰਾਦੇ ਦੀ ਨਾਕਾਮੀ ਨਹੀਂ। ਸਰਟੀਫਿਕੇਸ਼ਨ ਨੂੰ ਗਿਆਨ ਦਾ ਸਥਿਰ ਸਮੂਹ ਮੰਨਣ ਦੀ ਥਾਂ ਲਗਾਤਾਰ ਮੂਲ ਸਰੋਤ ਪੜ੍ਹੋ।
AI ਸੁਰੱਖਿਆ ਸਰਟੀਫਿਕੇਸ਼ਨ ਵਿੱਚ ਕੀ ਹੋਣਾ ਚਾਹੀਦਾ ਹੈ
ਮੌਜੂਦਾ AI ਸੁਰੱਖਿਆ ਅਮਲ ਦਰਸਾਉਣ ਲਈ ਸਰਟੀਫਿਕੇਸ਼ਨ ਪਾਠਕ੍ਰਮ ਵਿੱਚ ਇਹ ਵਿਸ਼ੇ ਹੋਣੇ ਚਾਹੀਦੇ ਹਨ:
- Prompt injection ਲਈ ਬਹੁ-ਪਰਤੀ ਬਚਾਅ: input filtering, output validation, tool scoping, sandboxing ਅਤੇ ਮਨੁੱਖੀ ਮਨਜ਼ੂਰੀ ਦੇ ਪੜਾਅ, ਨਾਲ ਹਰ ਇੱਕ ਦੀਆਂ ਦਰਜ ਹੱਦਾਂ
- Model supply chain ਦੀ ਤਸਦੀਕ: ਅਸੁਰੱਖਿਅਤ serialization ਜੋਖਮ, SBOM ਲੋੜਾਂ, provenance ਦਸਤਾਵੇਜ਼ ਅਤੇ signed artifacts ਦੀ ਤਸਦੀਕ
- AI agent ਸੁਰੱਖਿਆ ਢਾਂਚਾ: trust boundaries, ਘੱਟੋ-ਘੱਟ ਅਧਿਕਾਰ ਵਾਲੀ tool ਪਹੁੰਚ, ਕਾਰਵਾਈ ਵਾਪਸ ਕਰਨ ਦੀ ਸਮਰੱਥਾ ਅਤੇ ਨਿਗਰਾਨੀ ਦੀਆਂ ਲੋੜਾਂ
- MCP ਅਤੇ ਬਾਹਰੀ integration ਸੁਰੱਖਿਆ: tool servers ਦੇ ਭਰੋਸੇ ਦਾ ਮੁਲਾਂਕਣ, tool permissions ਦੀ ਜਾਂਚ ਅਤੇ ਡਾਟਾ ਤੇ ਹਦਾਇਤ ਵਿਚਲਾ ਫਰਕ
- ਮੁਲਾਂਕਣ ਅਤੇ red teaming: ਵਿਰੋਧੀ ਮੁਲਾਂਕਣ ਦਾ ਦਾਇਰਾ ਕਿਵੇਂ ਤੈਅ ਕਰਨਾ, ਕਿਹੜੇ benchmarks ਅਤੇ evaluation datasets ਮੌਜੂਦ ਹਨ ਅਤੇ ਨਤੀਜੇ ਕਿਵੇਂ ਸਮਝਣੇ
- AI observability: AI ਪ੍ਰਣਾਲੀਆਂ ਲਈ ਲੋੜੀਂਦੇ logs ਅਤੇ telemetry ਅਤੇ ਘਟਨਾ ਦੀ ਪਛਾਣ ਤੇ ਜਵਾਬ ਲਈ ਉਨ੍ਹਾਂ ਦੀ ਵਰਤੋਂ
- AI-ਵਿਸ਼ੇਸ਼ incident response: AI ਘਟਨਾਵਾਂ ਲਈ ਪਹਿਲਾਂ ਯੋਜਨਾ, ਮਾਡਲ ਵਿਹਾਰ ਨਾਲ ਜੁੜੇ ਸਵਾਲਾਂ ਲਈ ਸਬੂਤ ਇਕੱਠੇ ਕਰਨ ਅਤੇ AI ਦੀਆਂ ਖਾਸ ਮੁੜ-ਬਹਾਲੀ ਲੋੜਾਂ
- ਡਾਟਾ ਲੀਕ ਰੋਕਥਾਮ: RAG ਅਲੱਗਾਵ, prompt ਗੋਪਨੀਯਤਾ, multi-tenant ਪਹੁੰਚ ਨਿਯੰਤਰਣ ਅਤੇ output filtering
ਹੁਣ ਤੁਹਾਨੂੰ ਕੀ ਕਰਨਾ ਚਾਹੀਦਾ ਹੈ
ਜੇ ਤੁਸੀਂ ਆਪਣੇ ਸੰਗਠਨ ਦੀਆਂ AI ਪ੍ਰਣਾਲੀਆਂ ਲਈ ਜ਼ਿੰਮੇਵਾਰ ਹੋ:
OWASP Top 10 for Large Language Model Applications ਅਤੇ OWASP Agentic AI Top 10 ਪੜ੍ਹੋ। ਇਹ ਮੁਫ਼ਤ ਹਨ। ਮੌਜੂਦਾ ਭੁਗਤਾਨ ਵਾਲੇ ਸਰਟੀਫਿਕੇਸ਼ਨ ਪਾਠਕ੍ਰਮਾਂ ਨਾਲੋਂ ਇਨ੍ਹਾਂ ਵਿੱਚ ਅਮਲੀ ਵੇਰਵਾ ਵਧੇਰੇ ਹੈ।
AI ਹਿੱਸੇ ਬਾਰੇ ਅਗਲਾ threat modeling ਸੈਸ਼ਨ ਕਰਨ ਤੋਂ ਪਹਿਲਾਂ MITRE ATLAS ਦੀ ਸਮੀਖਿਆ ਕਰੋ। deployment ਡਿਜ਼ਾਇਨ ਅੰਤਿਮ ਕਰਨ ਤੋਂ ਪਹਿਲਾਂ ਜਾਣੋ ਕਿ ਤੁਹਾਡੇ ਢਾਂਚੇ ਉੱਤੇ ਹਮਲਾਵਰ ਦੀਆਂ ਕਿਹੜੀਆਂ ਤਕਨੀਕਾਂ ਲਾਗੂ ਹੁੰਦੀਆਂ ਹਨ।
NIST AI 600-1 ਪੜ੍ਹੋ। ਇਹ ਮੁੱਢਲੇ AI RMF ਨੂੰ ਖਾਸ ਤੌਰ ਉੱਤੇ generative AI ਲਈ ਵਧਾਉਂਦਾ ਹੈ ਅਤੇ ਸਿਰਫ਼ ਮੁੱਢਲੇ ਢਾਂਚੇ ਨਾਲੋਂ LLM ਅਤੇ agent deployments ਲਈ ਕਾਫ਼ੀ ਵਧੇਰੇ ਸਬੰਧਤ ਹੈ।
Google SAIF, Microsoft’s AI SDL ਅਤੇ OWASP AI Exchange ਵੇਖੋ। ਇਹ ਉਹ ਇੰਜੀਨੀਅਰਿੰਗ ਮਾਰਗਦਰਸ਼ਨ ਦਿੰਦੇ ਹਨ ਜੋ ਗਵਰਨੈਂਸ ਢਾਂਚਿਆਂ ਵਿੱਚ ਨਹੀਂ ਹੈ।
ਤੁਹਾਡਾ ਸੰਗਠਨ ਹਰ ਤਾਇਨਾਤ ਮਾਡਲ ਦਾ provenance ਤਸਦੀਕ ਕਰੇ। Model cards ਜਾਂਚੋ। Weights ਲੋਡ ਕਰਨ ਤੋਂ ਪਹਿਲਾਂ serialization formats ਨੂੰ ਜਾਣੀਆਂ exploit ਕਿਸਮਾਂ ਲਈ scan ਕਰੋ।
ਆਪਣੇ ਵਾਤਾਵਰਣ ਦੇ ਹਰ AI agent ਦੀ ਪਹੁੰਚ ਦਰਜ ਕਰੋ। ਅੰਦਰੂਨੀ knowledge base, email ਅਤੇ file system ਪੜ੍ਹਨ ਤੇ ਲਿਖਣ ਦੀ ਪਹੁੰਚ ਵਾਲਾ agent prompt injection ਦੇ ਅਸਰ ਨੂੰ ਵਧਾਉਂਦਾ ਹੈ। ਹਰ ਕੰਮ ਲਈ ਲੋੜੀਂਦੇ credentials ਤੱਕ ਇਸ ਦੀ ਪਹੁੰਚ ਘਟਾਓ।
ਕਿਸੇ ਵੀ ਮਾਡਲ ਜਾਂ agent ਨੂੰ ਉੱਚ-ਨਤੀਜਾ ਵਾਲੇ ਸੰਦਰਭ ਵਿੱਚ ਤਾਇਨਾਤ ਕਰਨ ਤੋਂ ਪਹਿਲਾਂ AI-ਵਿਸ਼ੇਸ਼ red teaming ਲਾਜ਼ਮੀ ਕਰੋ। ਇਸ ਨੂੰ ਵਿਕਲਪ ਨਹੀਂ, ਸ਼ਰਤ ਮੰਨੋ।
ਲੋੜ ਪੈਣ ਤੋਂ ਪਹਿਲਾਂ AI-ਵਿਸ਼ੇਸ਼ incident response runbooks ਬਣਾਓ।
ਆਪਣੇ ਗਵਰਨੈਂਸ ਸਰਟੀਫਿਕੇਸ਼ਨ ਨੂੰ ਪ੍ਰਕਿਰਿਆ ਵਾਲੀ ਪਰਤ ਦੇ ਦਸਤਾਵੇਜ਼ ਵਜੋਂ ਮੰਨੋ। ਇਹ ਤੁਹਾਡੀ ਸੁਰੱਖਿਆ ਸਥਿਤੀ ਦਾ ਦਸਤਾਵੇਜ਼ ਨਹੀਂ ਹੈ।
ਹਵਾਲੇ
- NIST AI Risk Management Framework (AI RMF 1.0), 2023
- NIST AI 600-1: Generative AI Profile, 2024
- NIST SP 1270: Towards a Standard for Identifying and Managing Bias in Artificial Intelligence
- ISO/IEC 42001:2023 Artificial Intelligence Management Systems
- EU AI Act, Regulation (EU) 2024/1689
- OWASP Top 10 for Large Language Model Applications, 2025
- OWASP Agentic AI Top 10
- OWASP AI Exchange
- MITRE ATLAS: Adversarial Threat Landscape for AI Systems
- Google Secure AI Framework (SAIF)
- Microsoft AI Security SDL documentation
- CISA Guidance on AI Cybersecurity, 2024
- Barreno et al., Can Machine Learning Be Secure?, 2006
- Biggio et al., Poisoning Attacks Against Support Vector Machines, 2012
- Goodfellow et al., Explaining and Harnessing Adversarial Examples, ICLR 2015
- IAPP AI Governance Professional (AIGP) program documentation
- ISACA AI Fundamentals Certificate program documentation
Related Posts