ਸਾਡੇ ਹਾਈਬ੍ਰਿਡ ਏਜੰਟਿਕ AI ਫਲੀਟ ਦੇ ਅੰਦਰ: Hermes, LiteLLM ਅਤੇ Tailscale

Table of Contents
ਅਸੀਂ ਬੇਨਤੀ ਅਨੁਸਾਰ ਸਥਾਨਕ GPU ਦੇਣ ਵਾਲਾ ਫਲੀਟ ਤੈਨਾਤ ਕੀਤਾ ਅਤੇ ਇਸ ਦਾ ਹਾਈਬ੍ਰਿਡ ਕੰਟਰੋਲ ਪਲੇਨ ਬਣਾਇਆ। ਤਸਦੀਕਸ਼ੁਦਾ ਰਸਤਾ LiteLLM ਤੋਂ ਸ਼ੁਰੂ ਹੁੰਦਾ ਹੈ, ਮਾਡਲ ਪੂਲ ਚੁਣਦਾ ਹੈ ਅਤੇ ਇੱਕ ਵੇਲੇ ਇੱਕ GPU ਉੱਤੇ ਸਥਾਨਕ ਮਾਡਲ ਲੋਡ ਕਰਦਾ ਹੈ। Hermes ਦੀ tier ਨੀਤੀ ਪ੍ਰਸਤਾਵਿਤ ਹੈ ਅਤੇ Tailscale Aperture ਦਾ configuration artifact ਅਗਲੇ integration test ਲਈ ਤਿਆਰ ਹੈ। ਦੋਵਾਂ ਵਿੱਚੋਂ ਕਿਸੇ ਨੂੰ ਵੀ ਪੂਰੇ end-to-end ਰਸਤੇ ਦਾ ਹਿੱਸਾ ਹੋਣ ਵਜੋਂ ਤਸਦੀਕ ਨਹੀਂ ਕੀਤਾ ਗਿਆ।
ਵਿਹਲੇ ਕਾਰਡ Pearl ਮਾਈਨ ਕਰਦੇ ਹਨ। AI ਬੇਨਤੀ ਸਿਰਫ਼ ਕਿਰਾਏ ਉੱਤੇ ਲਏ ਕਾਰਡ ਦੀ ਮਾਈਨਿੰਗ ਰੋਕਦੀ ਹੈ, ਬੇਨਤੀ ਪੂਰੀ ਕਰਦੀ ਹੈ, ਮਾਡਲ unload ਕਰਦੀ ਹੈ ਅਤੇ ਕਾਰਡ ਨੂੰ miner ਕੋਲ ਵਾਪਸ ਭੇਜਦੀ ਹੈ।
ਮੁੱਖ ਨੁਕਤੇ
- T0 ਤੋਂ T2 ਮਹਿੰਗੇ ਜਾਂ ਔਖੇ ਕੰਮ ਸੰਭਾਲਦੇ ਹਨ। ਇਹ ਰਸਤੇ hosted frontier ਮਾਡਲਾਂ ਅਤੇ ਕ੍ਰਮਬੱਧ fallback chain ਨੂੰ ਤਰਜੀਹ ਦਿੰਦੇ ਹਨ।
- T3 ਵੱਡੇ ਸਥਾਨਕ ਕੰਮ ਸੰਭਾਲਦਾ ਹੈ। ਫਲੀਟ planning, coding, review ਅਤੇ vision ਨੂੰ 4B ਤੋਂ 12B ਮਾਡਲਾਂ ਨੂੰ ਦਿੰਦਾ ਹੈ।
- T4 ਵੱਧ ਮਾਤਰਾ ਵਾਲੇ ਸਥਾਨਕ ਕੰਮ ਸੰਭਾਲਦਾ ਹੈ। ਛੋਟੇ ਮਾਡਲ routing, classification, extraction, embedding ਅਤੇ ਸੀਮਿਤ code task ਕਰਦੇ ਹਨ।
- ਹਰ GPU ਵੱਖਰਾ ਸਰੋਤ ਹੈ। ਇੱਕ ਕਾਰਡ AI ਸੇਵਾ ਦਿੰਦਾ ਹੈ ਤੇ ਬਾਕੀ ਕਾਰਡ ਮਾਈਨਿੰਗ ਕਰਦੇ ਰਹਿੰਦੇ ਹਨ।
- ਵਿਹਲੇ ਸਮੇਂ ਸਥਾਨਕ ਮਾਡਲ unload ਰਹਿੰਦੇ ਹਨ। ਬੇਨਤੀਆਂ ਦੇ ਵਿਚਕਾਰ ਕੋਈ ਮਾਡਲ GPU memory ਨਹੀਂ ਰੋਕਦਾ।
- ਹਰ gateway ਉਹੀ logical catalog ਦਿਖਾਉਂਦਾ ਹੈ। ਸਾਂਝੇ alias ਯੋਗ ਸਿਸਟਮਾਂ ਵਿੱਚ ਕੰਮ ਵੰਡਦੇ ਹਨ। ਲੋੜ ਪੈਣ ਉੱਤੇ node-prefixed alias ਸਹੀ ਥਾਂ ਕਾਇਮ ਰੱਖਦੇ ਹਨ।
- ਤਜਰਬਾਤੀ broker production ਵਿੱਚ ਨਹੀਂ ਗਿਆ। ਇਸ ਦੇ canary ਨੇ ਇੱਕ ਬੇਨਤੀ ਪੂਰੀ ਕੀਤੀ, ਪਰ ਸਾਫ਼ shutdown test ਵਿੱਚ ਅਸਫਲ ਰਿਹਾ। LiteLLM ਤਸਦੀਕਸ਼ੁਦਾ request-scoped ਰਸਤੇ ਉੱਤੇ ਰਿਹਾ।
- Hermes ਅਤੇ Aperture ਹਾਲੇ ਤਿਆਰੀ ਵਿੱਚ ਹਨ। ਲਕਸ਼ਿਤ design ਮੌਜੂਦ ਹੈ, ਪਰ end-to-end acceptance test ਬਾਕੀ ਹੈ।
ਲੋੜੀਂਦੀਆਂ ਚੀਜ਼ਾਂ: ਕਈ Linux GPU host, ਸਥਿਰ NVIDIA driver, Tailscale tailnet, systemd, ਚੱਲਦਾ miner, ਮਾਡਲਾਂ ਲਈ storage ਅਤੇ ਹਰ model route ਲਈ acceptance test।
ਸਮਾਂ ਅਤੇ ਔਖਿਆਈ: ਉੱਨਤ। inventory, model download, service definition, routing test, failure drill ਅਤੇ ਹਰ ਕਾਰਡ ਲਈ mining recovery check ਨੂੰ ਕਈ ਦਿਨ ਦਿਓ।
ਹੇਠਾਂ ਵਰਤੇ ਸ਼ਬਦ: tailnet Tailscale ਪਛਾਣਾਂ ਅਤੇ ਡਿਵਾਈਸਾਂ ਨਾਲ ਬਣਿਆ ਨਿੱਜੀ ਨੈੱਟਵਰਕ ਹੈ। model alias ਕਲਾਇੰਟਾਂ ਨੂੰ ਦਿਖਾਇਆ ਸਥਿਰ ਮਾਡਲ ਨਾਮ ਹੈ। model group ਇੱਕ alias ਪਿੱਛੇ ਕਈ deployment ਰੱਖਦਾ ਹੈ। pool proxy ਛੋਟੀ ਸਥਾਨਕ service ਹੈ ਜੋ GPU ਕਿਰਾਏ ਉੱਤੇ ਲੈਂਦੀ, model worker ਸ਼ੁਰੂ ਕਰਦੀ ਅਤੇ ਕਾਰਡ ਨੂੰ ਮਾਈਨਿੰਗ ਵਿੱਚ ਵਾਪਸ ਭੇਜਦੀ ਹੈ।
ਡਿਜ਼ਾਈਨ ਦਾ ਟੀਚਾ
ਏਜੰਟਿਕ ਕੰਮ ਕਈ ਰੂਪਾਂ ਵਿੱਚ ਆਉਂਦਾ ਹੈ। repository ਦੀ ਮੁਰੰਮਤ ਲਈ ਉਹ ਮਾਡਲ ਨਹੀਂ ਚਾਹੀਦਾ ਜੋ title, screenshot, embedding ਜਾਂ intent label ਲਈ ਚਾਹੀਦਾ ਹੈ। ਹਰ turn ਵੱਡੇ ਤੋਂ ਵੱਡੇ ਮਾਡਲ ਨੂੰ ਭੇਜਣ ਨਾਲ ਪੈਸਾ ਅਤੇ ਸਥਾਨਕ ਸਮਰੱਥਾ ਵਿਅਰਥ ਜਾਂਦੀ ਹੈ। ਹਰ turn ਸਭ ਤੋਂ ਛੋਟੇ ਮਾਡਲ ਨੂੰ ਭੇਜਣ ਨਾਲ retry ਵਧਦੇ ਅਤੇ ਨਤੀਜੇ ਕਮਜ਼ੋਰ ਹੁੰਦੇ ਹਨ।
ਅਸੀਂ ਪੰਜ workload band ਵਾਲਾ ਇੱਕ catalog ਚਾਹੁੰਦੇ ਸੀ। ਨੀਤੀ ਨੂੰ ਜਾਣੇ-ਪਛਾਣੇ API format ਰਾਹੀਂ hosted ਅਤੇ ਸਥਾਨਕ ਮਾਡਲ ਸੇਵਾ ਦੇਣੀ ਸੀ। AI ਬੇਨਤੀਆਂ ਦੇ ਵਿਚਕਾਰ ਸਥਾਨਕ GPU ਨੂੰ ਲਾਭਕਾਰੀ ਰੱਖਣਾ ਸੀ।
ਫਲੀਟ ਨੂੰ concurrency ਵੀ ਚਾਹੀਦੀ ਸੀ। ਕਈ ਕਾਰਡਾਂ ਵਾਲਾ host ਇੱਕੋ ਵੇਲੇ ਕਈ ਸੁਤੰਤਰ ਕੰਮ ਸੇਵਾ ਦੇਵੇ। ਇੱਕ ਕਾਰਡ ਦੀ ਬੇਨਤੀ chassis ਦੇ ਸਾਰੇ ਕਾਰਡਾਂ ਦੀ ਮਾਈਨਿੰਗ ਨਾ ਰੋਕੇ।
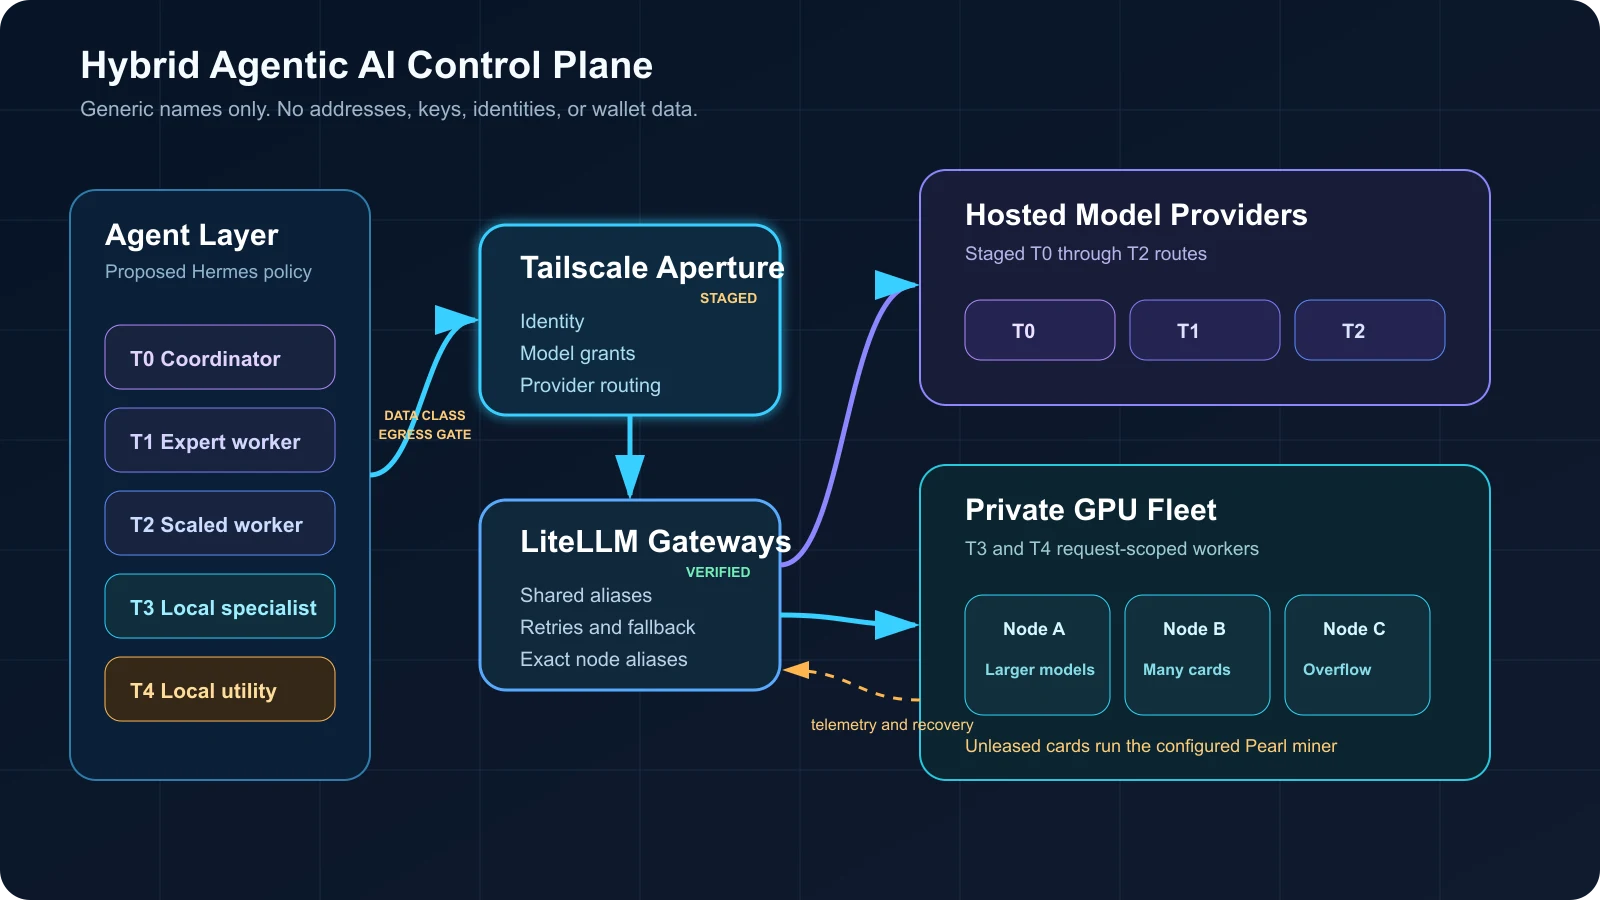
ਪ੍ਰਸਤਾਵਿਤ ਅਤੇ ਤਿਆਰੀ ਵਾਲਾ control path ਤਸਦੀਕਸ਼ੁਦਾ LiteLLM ਅਤੇ ਪ੍ਰਤੀ-GPU execution path ਦੇ ਉੱਪਰ ਹੈ
ਚਿੱਤਰ ਵਿੱਚ ਆਮ node ਨਾਮ ਵਰਤੇ ਹਨ। ਇਸ ਵਿੱਚ ਨਿੱਜੀ address, user identity, access key, wallet data ਜਾਂ ਅਸਲ host label ਸ਼ਾਮਲ ਨਹੀਂ।
T0 ਤੋਂ T4 ਦਾ ਮਤਲਬ
ਇਹ tier ਨਾਮ ਸਾਡੀ routing policy ਦੱਸਦੇ ਹਨ। ਇਹ ਉਦਯੋਗ ਦਾ ਮਿਆਰ ਨਹੀਂ ਅਤੇ ਸਿਰਫ਼ ਮਾਡਲ ਦਾ ਆਕਾਰ ਨਹੀਂ ਦੱਸਦੇ।
| ਪੱਧਰ | ਮੁੱਖ ਭੂਮਿਕਾ | ਆਮ ਟਿਕਾਣਾ | ਨਾਕਾਮੀ ਵੇਲੇ ਰਵੱਈਆ |
|---|---|---|---|
| T0 | ਮੂਲ ਤਾਲਮੇਲਕ ਅਤੇ ਸਭ ਤੋਂ ਔਖੇ ਫ਼ੈਸਲੇ | ਹੋਸਟ ਕੀਤਾ ਉੱਚ ਪੱਧਰੀ ਤਰਕ ਮਾਡਲ | ਕ੍ਰਮਵਾਰ ਬਦਲਵੀਂ ਲੜੀ |
| T1 | ਵੱਧ ਮੁੱਲ ਵਾਲਾ worker ਏਜੰਟ | ਉੱਚ ਸਮਰੱਥਾ ਵਾਲੇ ਹੋਸਟ ਕੀਤੇ ਮਾਡਲਾਂ ਦਾ ਸਮੂਹ | ਨਿਰਧਾਰਤ ਲੜੀ ਵਿੱਚ ਮੁੜ ਕੋਸ਼ਿਸ਼ |
| T2 | ਆਮ worker ਸਮੂਹ | ਲੋੜ ਪੈਣ ਉੱਤੇ ਉੱਚੇ ਪੱਧਰ ਵੱਲ ਭੇਜਣ ਵਾਲੇ ਤੇਜ਼ ਹੋਸਟ ਕੀਤੇ ਮਾਡਲ | ਔਖੇ ਕੰਮ T1 ਜਾਂ T0 ਵੱਲ ਭੇਜੋ |
| T3 | ਵੱਡੇ ਨਿੱਜੀ ਸਥਾਨਕ ਕੰਮ | 4B ਤੋਂ 12B ਸਥਾਨਕ ਗੱਲਬਾਤ, ਕੋਡ, ਸਮੀਖਿਆ ਅਤੇ ਵਿਜ਼ਨ ਮਾਡਲ | ਯੋਗ ਸਥਾਨਕ node ਉੱਤੇ ਮੁੜ ਕੋਸ਼ਿਸ਼, ਫਿਰ ਪਾਬੰਦੀਸ਼ੁਦਾ ਜਾਣਕਾਰੀ ਲਈ ਸੁਰੱਖਿਅਤ ਇਨਕਾਰ |
| T4 | ਸੀਮਿਤ ਅਤੇ ਵਾਰ-ਵਾਰ ਹੋਣ ਵਾਲੇ ਸਥਾਨਕ ਕੰਮ | 0.6B ਤੋਂ 3B ਸਥਾਨਕ ਰੂਟਿੰਗ, ਵਰਗੀਕਰਨ, ਕੋਡ ਅਤੇ ਐਂਬੈਡਿੰਗ ਮਾਡਲ | ਸਥਾਨਕ ਨਕਲ ਉੱਤੇ ਮੁੜ ਕੋਸ਼ਿਸ਼ ਜਾਂ ਉਸੇ ਜਾਣਕਾਰੀ ਹੱਦ ਵਿੱਚ T3 ਵੱਲ ਜਾਓ |
Tier ਪਹਿਲਾਂ ਕੰਮ ਦਾ, ਫਿਰ ਮਾਡਲ ਦਾ ਵਰਣਨ ਕਰਦੇ ਹਨ। ਸੁਰੱਖਿਆ-ਸੰਵੇਦਨਸ਼ੀਲ ਛੋਟੀ classification T4 ਵਿੱਚ ਆਉਂਦੀ ਹੈ। ਲੰਮੀ repository ਯੋਜਨਾ T3 ਜਾਂ ਉੱਪਰ ਆਉਂਦੀ ਹੈ। ਔਖਾ architecture ਫ਼ੈਸਲਾ ਛੋਟੇ prompt ਦੇ ਬਾਵਜੂਦ ਉੱਚੇ tier ਤੋਂ ਸ਼ੁਰੂ ਹੁੰਦਾ ਹੈ।
ਇਹ ਵੰਡ agent economics ਵੀ ਬਦਲਦੀ ਹੈ। T4 worker ਵਾਰ-ਵਾਰ ਹੋਣ ਵਾਲੇ ਘੱਟ-ਖ਼ਤਰੇ ਦੇ ਬਦਲਾਅ ਸੰਭਾਲਦੇ ਹਨ। T3 worker ਆਮ code ਅਤੇ analysis ਨੂੰ tailnet ਅੰਦਰ ਰੱਖਦੇ ਹਨ। ਔਖੇ ਕੰਮ ਅਤੇ failure recovery ਲਈ T0 ਤੋਂ T2 ਉਪਲਬਧ ਰਹਿੰਦੇ ਹਨ।
ਹਰ hosted fallback ਤੋਂ ਪਹਿਲਾਂ data-class gate ਹੋਣਾ ਚਾਹੀਦਾ ਹੈ। Public, internal ਅਤੇ restricted ਕੰਮਾਂ ਲਈ ਵੱਖਰੀ chain ਹੁੰਦੀ ਹੈ। Restricted ਕੰਮ ਸਥਾਨਕ ਰਹਿੰਦਾ ਅਤੇ ਨਾਕਾਮ ਹੋਣ ਉੱਤੇ fail closed ਕਰਦਾ ਹੈ। Data boundary ਪਾਰ ਕਰਦੀ retry ਲਈ ਸਾਫ਼ ਕੀਤਾ input ਅਤੇ user ਜਾਂ workflow ਦੀ ਸਪਸ਼ਟ ਮਨਜ਼ੂਰੀ ਲੋੜੀਂਦੀ ਹੈ। Hosted call ਤੋਂ ਪਹਿਲਾਂ redaction credential, repository secret, ਨਿੱਜੀ tool output ਅਤੇ ਸੰਵੇਦਨਸ਼ੀਲ retrieval content ਹਟਾਉਂਦੀ ਹੈ।
Hermes ਕੰਮ ਦੀ ਨੀਤੀ ਕਿਵੇਂ ਸੰਭਾਲੇਗਾ
Hermes ਪ੍ਰਸਤਾਵਿਤ agent layer ਹੈ। ਟੀਚਾ policy model class ਨਿਰਧਾਰਤ ਕਰਦੀ, tools ਚਲਾਉਂਦੀ, ਕੰਮ ਸੌਂਪਦੀ ਅਤੇ ਸਪਸ਼ਟ fallback chain ਅਨੁਸਾਰ ਜਾਂਦੀ ਹੈ। Hermes ਮੁੱਖ ਮਾਡਲ, ਸਹਾਇਕ ਕੰਮ, ਸੌਂਪੇ agent ਅਤੇ task-specific fallback ਲਈ ਵੱਖਰੇ ਰਸਤੇ ਦਰਜ ਕਰਦਾ ਹੈ। ਇਹ base URL ਰਾਹੀਂ custom OpenAI-compatible endpoint ਵੀ ਸਹਾਇਕ ਕਰਦਾ ਹੈ। Hermes ਸੰਰਚਨਾ ਮਾਰਗਦਰਸ਼ਿਕਾ ਅਤੇ ਵਿਕਲਪਕ provider ਮਾਰਗਦਰਸ਼ਿਕਾ ਵੇਖੋ।
ਸਾਡੀ policy Hermes ਕੰਮਾਂ ਨੂੰ physical server ਦੀ ਥਾਂ ਸਥਿਰ alias ਨਾਲ ਜੋੜਦੀ ਹੈ। ਉਦਾਹਰਨਾਂ:
t3-smart
t3-code
t3-review
t3-vision
t4-code
t4-classify
t4-router
t4-embedding
Alias ਕੰਮ ਦਾ ਮਨੋਰਥ ਦੱਸਦਾ ਹੈ। Hermes ਨੂੰ ਇਹ ਜਾਣਨ ਦੀ ਲੋੜ ਨਹੀਂ ਕਿ ਕਿਹੜਾ GPU ਖਾਲੀ ਹੈ, ਕਿਹੜੇ node ਉੱਤੇ ਵੱਡਾ ਕਾਰਡ ਹੈ ਜਾਂ ਕਿਹੜਾ replica health check ਵਿੱਚ ਨਾਕਾਮ ਹੋਇਆ। ਹੇਠਲੀਆਂ ਪਰਤਾਂ ਇਹ ਫ਼ੈਸਲੇ ਕਰਦੀਆਂ ਹਨ।
ਕੁਝ ਕੰਮਾਂ ਲਈ ਹਾਲੇ ਵੀ ਨਿਸ਼ਚਿਤ placement ਚਾਹੀਦੀ ਹੈ। Node-prefixed model ID operator diagnostic ਜਾਂ benchmark ਨੂੰ ਚੁਣੇ ਸਿਸਟਮ ਤੱਕ ਭੇਜਦਾ ਹੈ। ਵੱਖਰੇ Aperture grant ਇਨ੍ਹਾਂ alias ਨੂੰ operator ਤੱਕ ਸੀਮਿਤ ਰੱਖਣ। ਆਮ agent traffic ਸਾਂਝੇ tier alias ਵਰਤਦਾ ਹੈ।
Model access ਨਾਲ agent tool ਸੁਰੱਖਿਅਤ ਨਹੀਂ ਹੁੰਦੇ। Hermes rollout ਲਈ ਘੱਟੋ-ਘੱਟ privilege ਵਾਲੀ tool allowlist, ਅਲੱਗ workspace, ਸੀਮਿਤ credential, network egress control ਅਤੇ prompt injection handling ਚਾਹੀਦੀ ਹੈ। Delegated worker ਨੂੰ ਉਸ ਦੇ ਕੰਮ ਲਈ ਲੋੜ ਤੋਂ ਵੱਧ access ਨਹੀਂ ਮਿਲਣੀ ਚਾਹੀਦੀ।
Aperture ਤਿਆਰੀ ਵਾਲੀ ਪਛਾਣ ਹੱਦ ਹੈ
Tailscale ਹਰ service ਨੂੰ public internet ਉੱਤੇ ਪਾਏ ਬਿਨਾਂ configured gateway ਅਤੇ inference host ਜੋੜਦਾ ਹੈ। Aperture ਨੂੰ user-facing boundary ਅਤੇ model router ਵਜੋਂ ਤਿਆਰ ਕੀਤਾ ਜਾ ਰਿਹਾ ਹੈ। ਇਸ ਰਸਤੇ ਲਈ end-to-end acceptance test ਹਾਲੇ ਬਾਕੀ ਹੈ। Tailscale tailnet ਉੱਤੇ encrypted client access ਅਤੇ TLS ਰਾਹੀਂ provider forwarding ਦਾ ਵੇਰਵਾ Aperture ਕਿਵੇਂ ਕੰਮ ਕਰਦਾ ਹੈ ਵਿੱਚ ਦਿੰਦਾ ਹੈ।
Aperture ਪਹੁੰਚ ਅਤੇ ਇਜਾਜ਼ਤ ਨੂੰ ਵੀ ਵੱਖ ਕਰਦਾ ਹੈ। ਇਸ ਦੇ grant ਮੂਲ ਰੂਪ ਵਿੱਚ ਪਹੁੰਚ ਰੱਦ ਕਰਦੇ ਹਨ। Gateway ਤੱਕ ਪਹੁੰਚਣ ਤੋਂ ਬਾਅਦ user ਜਾਂ tagged device ਲਈ ਮਿਲਦਾ model grant ਲੋੜੀਂਦਾ ਹੈ। Aperture grant ਮਾਰਗਦਰਸ਼ਿਕਾ additive grant model ਅਤੇ identity source ਸਮਝਾਉਂਦਾ ਹੈ।
ਤੈਨਾਤੀ ਤੋਂ ਪਹਿਲਾਂ ਤਿਆਰ ਹੋ ਰਹੀ Aperture configuration ਨੂੰ ਚਾਰ ਨਿਯਮ ਮੰਨਣੇ ਚਾਹੀਦੇ ਹਨ:
- ਇੱਕ ਨਾਮਜ਼ਦ identity ਕੋਲ admin role ਹੈ। ਆਮ model access ਨਾਲ administration ਨਹੀਂ ਮਿਲਦੀ।
- Provider ਸਹੀ model ID ਲਿਖਦੇ ਹਨ। Aperture upstream service ਤੋਂ ਮਾਡਲ ਦਾ ਅੰਦਾਜ਼ਾ ਨਹੀਂ ਲਾਉਂਦਾ।
- Provider URL tailnet address ਵੱਲ ਜਾਂਦੇ ਹਨ। ਨਿੱਜੀ node ਨਾਮ ਅਤੇ address ਲੇਖ ਅਤੇ ਜਨਤਕ configuration ਉਦਾਹਰਨਾਂ ਤੋਂ ਬਾਹਰ ਰਹਿੰਦੇ ਹਨ।
- Secret service-owned file ਵਿੱਚ ਰਹਿੰਦੇ ਹਨ। ਤੈਨਾਤੀ ਤੋਂ ਪਹਿਲਾਂ owner-only permission, ਸੀਮਿਤ service account, rotation ਅਤੇ log redaction ਲਾਗੂ ਕਰੋ। Diagnostic output ਕਦੇ ਵੀ LiteLLM key, tailnet address, subscription token ਜਾਂ wallet data ਨਾ ਦਿਖਾਏ।
Aperture ਆਉਣ ਵਾਲੇ request path ਨੂੰ ਹਰ provider base URL ਦੇ ਅੰਤ ਵਿੱਚ ਜੋੜਦਾ ਹੈ। ਇਸ ਦਾ
ਸੰਰਚਨਾ ਹਵਾਲਾ
provider root ਵਿੱਚ ਦੁਹਰਾਇਆ /v1 suffix ਨਾ ਰੱਖਣ ਦੀ ਚੇਤਾਵਨੀ ਦਿੰਦਾ ਹੈ। Integration risk ਕਾਫ਼ੀ ਸੀ, ਇਸ ਲਈ ਇਸ ਲਈ ਖਾਸ validation check ਜੋੜਿਆ।
Vision image content ਸਮੇਤ OpenAI Chat Completions format ਵਿੱਚ ਜਾਣ ਲਈ ਤਿਆਰ ਹੈ। Embedding ਸਿੱਧਾ ਨਿੱਜੀ LiteLLM endpoint ਵਰਤਦੀ ਹੈ, ਕਿਉਂਕਿ Aperture ਦੀ ਮੌਜੂਦਾ self-hosted provider matrix chat format ਦਰਜ ਕਰਦੀ ਹੈ, ਜਦਕਿ ਸਾਡਾ embedding ਰਸਤਾ chat picker ਤੋਂ ਬਾਹਰ LiteLLM ਅਤੇ llama.cpp endpoint ਉੱਤੇ ਨਿਰਭਰ ਹੈ। ਸਹਾਇਕ provider ਅਤੇ client ਦਾ ਹਵਾਲਾ ਵੇਖੋ।
ਸਿੱਧੇ embedding route ਨੂੰ ਆਪਣੀ authorization boundary ਚਾਹੀਦੀ ਹੈ। LiteLLM authentication, ਸਖ਼ਤ Tailscale grant, tailnet interface ਨਾਲ service binding ਅਤੇ host firewall rule ਰਾਹੀਂ ਪਹੁੰਚ ਨੂੰ ਮਨਜ਼ੂਰਸ਼ੁਦਾ identity ਜਾਂ service tag ਤੱਕ ਸੀਮਿਤ ਰੱਖਣਾ ਚਾਹੀਦਾ ਹੈ। ਸਿਰਫ਼ ਨਿੱਜੀ address authorization policy ਨਹੀਂ ਹੈ।
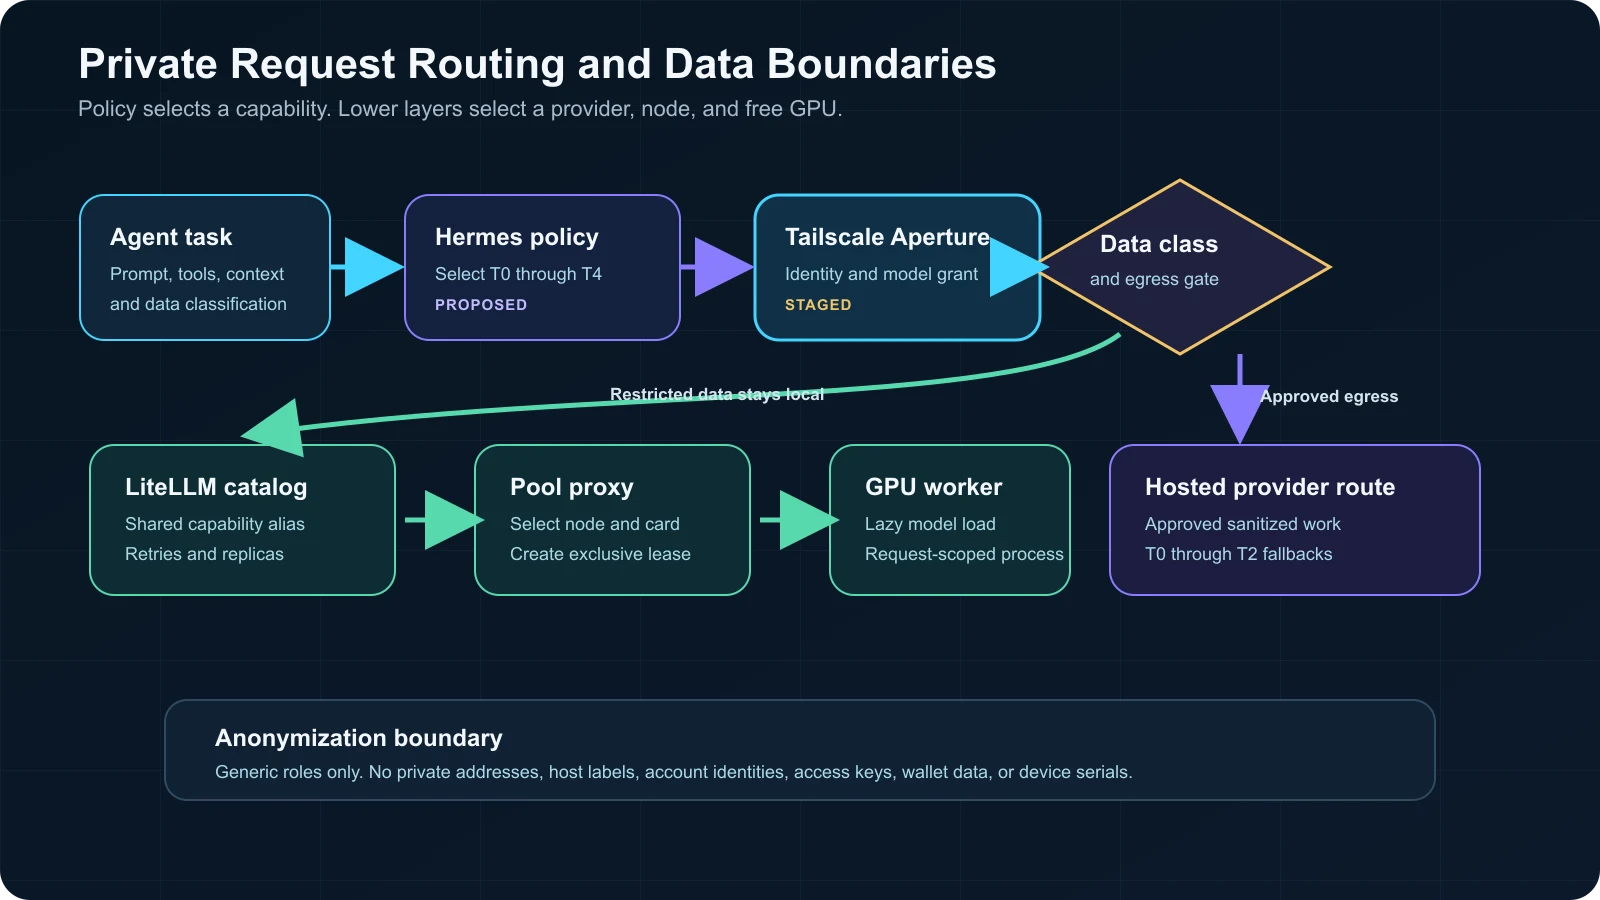
Identity, grant ਅਤੇ data classification ਫ਼ੈਸਲਾ ਕਰਦੇ ਹਨ ਕਿ ਬੇਨਤੀ ਨਿੱਜੀ ਫਲੀਟ ਤੋਂ ਬਾਹਰ ਜਾਵੇਗੀ ਜਾਂ ਨਹੀਂ
LiteLLM ਇੱਕ ਸੂਚੀ ਪੇਸ਼ ਕਰਦਾ ਹੈ
ਹਰ inference host LiteLLM gateway ਚਲਾਉਂਦਾ ਹੈ। ਮਾਡਲ ਕਿਸੇ ਹੋਰ node ਉੱਤੇ ਹੋਵੇ ਤਦ ਵੀ ਹਰ gateway ਉਹੀ logical model catalog ਪੇਸ਼ ਕਰਦਾ ਹੈ। ਕਲਾਇੰਟ ਇੱਕ API shape ਅਤੇ alias ਦਾ ਇੱਕੋ set ਵਰਤਦਾ ਹੈ।
LiteLLM ਕਈ deployment ਨੂੰ ਇੱਕ model name ਹੇਠ ਜੋੜਦਾ ਹੈ। ਇਸ ਦਾ router ਫਿਰ ਯੋਗ deployment ਚੁਣਦਾ ਅਤੇ retry, timeout, cooldown ਜਾਂ fallback ਲਾਗੂ ਕਰਦਾ ਹੈ। ਮੌਜੂਦਾ LiteLLM routing ਦਸਤਾਵੇਜ਼ ਸਾਂਝੇ model name, routing strategy ਅਤੇ retry behavior ਦੱਸਦੀ ਹੈ।
Catalog ਵਿੱਚ ਦੋ address style ਹਨ:
| Address style | ਉਦਾਹਰਨ | ਵਰਤੋਂ |
|---|---|---|
| Shared alias | t4-classify | ਯੋਗ node ਵਿਚਕਾਰ ਆਮ ਕੰਮ ਵੰਡਣਾ |
| Node alias | node-b/qwen-small | Diagnostic ਚਲਾਉਣਾ ਜਾਂ placement ਕਾਇਮ ਰੱਖਣਾ |
ਸਾਂਝੇ alias Hermes ਨੂੰ ਬਦਲੇ ਬਿਨਾਂ horizontal scale ਦਿੰਦੇ ਹਨ। ਯੋਗ replica ਜੋੜਨ ਨਾਲ model group ਵਧਦਾ ਹੈ। ਖ਼ਰਾਬ replica ਹਟਾਉਣ ਨਾਲ group ਛੋਟਾ ਹੁੰਦਾ ਹੈ।
GPU lifecycle logic LiteLLM ਤੋਂ ਹੇਠਾਂ ਰੱਖੀ ਹੈ। Gateway ਚੱਲਦਾ ਰਹਿੰਦਾ ਹੈ ਕਿਉਂਕਿ ਇਸ ਦੀ memory footprint GPU memory ਨਹੀਂ ਰੋਕਦੀ। ਸਥਾਨਕ pool proxy ਚੁਣੇ ਮਾਡਲ ਦੀ ਬੇਨਤੀ ਲੈਂਦੀ, ਇੱਕ ਕਾਰਡ ਕਿਰਾਏ ਉੱਤੇ ਲੈਂਦੀ, worker ਸ਼ੁਰੂ ਕਰਦੀ ਅਤੇ ਜਵਾਬ ਤੋਂ ਬਾਅਦ ਉਸ ਨੂੰ ਬੰਦ ਕਰਦੀ ਹੈ।
ਸਥਾਨਕ ਮਾਡਲ ਸੂਚੀ
ਫਲੀਟ 12B parameter ਜਾਂ ਇਸ ਤੋਂ ਛੋਟੇ ਮਾਡਲਾਂ ਨੂੰ ਤਰਜੀਹ ਦਿੰਦਾ ਹੈ। ਇਹ ਹੱਦ ਮੌਜੂਦਾ ਕਾਰਡਾਂ ਦੀ memory ਨਾਲ ਮੇਲ ਖਾਂਦੀ ਅਤੇ context ਅਤੇ runtime buffer ਲਈ ਥਾਂ ਛੱਡਦੀ ਹੈ।
Model notation: B ਦਾ ਮਤਲਬ ਅਰਬਾਂ parameter ਹੈ। K configured context token ਦੇ ਹਜ਼ਾਰ ਹਨ। Quantization ਮਾਡਲ ਦੇ weight ਘੱਟ numeric precision ਨਾਲ ਰੱਖ ਕੇ memory ਵਰਤੋਂ ਘਟਾਉਂਦੀ ਹੈ। KV cache ਸਰਗਰਮ context ਦੀ attention state ਰੱਖਦੀ ਅਤੇ prompt ਲੰਮਾ ਹੋਣ ਨਾਲ ਵਧਦੀ ਹੈ। E4B ਛੋਟੀ Gemma 4 variant ਲਈ Google ਦਾ size label ਹੈ।
| Tier ਰਸਤਾ | ਮਾਡਲ ਦੀ ਕਿਸਮ | ਨਿਰਧਾਰਤ ਸੰਦਰਭ | ਮੁੱਖ ਕੰਮ | ਟਿਕਾਣਾ |
|---|---|---|---|---|
| T3 ਸਮਝਦਾਰ | Qwen3.5 9B, quantized | 64K | ਔਖੀ ਸਥਾਨਕ planning ਅਤੇ ਆਮ agent ਕੰਮ | ਵੱਧ memory ਵਾਲੇ GPU node |
| T3 ਕੋਡ | Granite 4.2 8B, quantized | 64K | Repository ਕੰਮ, tool, terminal task, structured output | ਵੱਧ memory ਵਾਲੇ GPU node |
| T3 ਸਮੀਖਿਆ | Gemma 4 12B, quantized | 32K | ਸੁਤੰਤਰ review ਅਤੇ ਬਦਲਵੀਂ reasoning | ਵੱਧ memory ਵਾਲੇ GPU node |
| T3 ਆਮ ਕੰਮ ਅਤੇ ਵਿਜ਼ਨ | Qwen3.5 4B, quantized | 32K | ਫੈਲਿਆ ਆਮ ਕੰਮ ਅਤੇ image ਸਮਝ | ਹਰ compatible GPU |
| T3 ਬਦਲਵੀਂ ਸਮੀਖਿਆ | Gemma 4 E4B, quantized | 8K | ਵੱਖਰਾ review ਰਸਤਾ | ਹਰ compatible GPU |
| T4 ਕੋਡ | Granite 4.2 3B, quantized | 16K | ਛੋਟੇ edit, tool call, structured output | ਹਰ compatible GPU |
| T4 ਵਰਗੀਕਰਨ | Qwen3.5 2B, quantized | 16K | Classification, extraction ਅਤੇ rewriting | ਹਰ compatible GPU |
| T4 ਰਾਊਟਰ | Qwen3.5 0.8B, high precision quantization | 16K | Intent, label, title ਅਤੇ ਛੋਟੇ ਬਦਲਾਅ | ਹਰ compatible GPU |
| T4 ਐਂਬੈਡਿੰਗ | Qwen3 Embedding 0.6B, quantized | 32K | Agent memory, RAG, code retrieval ਅਤੇ clustering | ਹਰ compatible GPU |
ਇਹ context value deployment setting ਹਨ, ਮਾਡਲ ਦੀਆਂ advertised ਹੱਦਾਂ ਨਹੀਂ। ਵੱਡੀ advertised window ਵੀ KV cache ਅਤੇ runtime memory ਵਰਤਦੀ ਹੈ। ਇੱਕ ਕਾਰਡ ਉੱਤੇ ਸਥਿਰ service ਲਈ ਅਸੀਂ ਘੱਟ value ਚੁਣੀਆਂ।
Qwen Qwen3.5 ਨੂੰ multimodal family ਦੱਸਦਾ ਅਤੇ Qwen3.5 ਸੰਗ੍ਰਹਿ ਵਿੱਚ ਛੋਟੇ ਤੋਂ ਵੱਡੇ dense variant ਜਾਰੀ ਕਰਦਾ ਹੈ। IBM Granite 4.2 8B ਲਈ agentic coding ਅਤੇ ਲੰਮੇ context ਦੇ ਨਤੀਜੇ ਦਿੰਦਾ ਹੈ। Google ਕਹਿੰਦਾ ਹੈ ਕਿ Gemma 4 multimodal input, function calling ਅਤੇ ਵੱਡੀ advertised window ਸਹਾਇਕ ਕਰਦਾ ਹੈ।
Embedding ਰਸਤਾ chat model ਤੋਂ vector ਮੰਗਣ ਦੀ ਥਾਂ ਵੱਖਰਾ ਮਾਡਲ ਵਰਤਦਾ ਹੈ। Qwen3 Embedding 0.6B ਮਾਡਲ ਕਾਰਡ ਵਿੱਚ 32K sequence length, ਬਹੁਭਾਸ਼ੀ retrieval, code retrieval ਅਤੇ 1,024 ਤੱਕ output dimension ਹਨ।
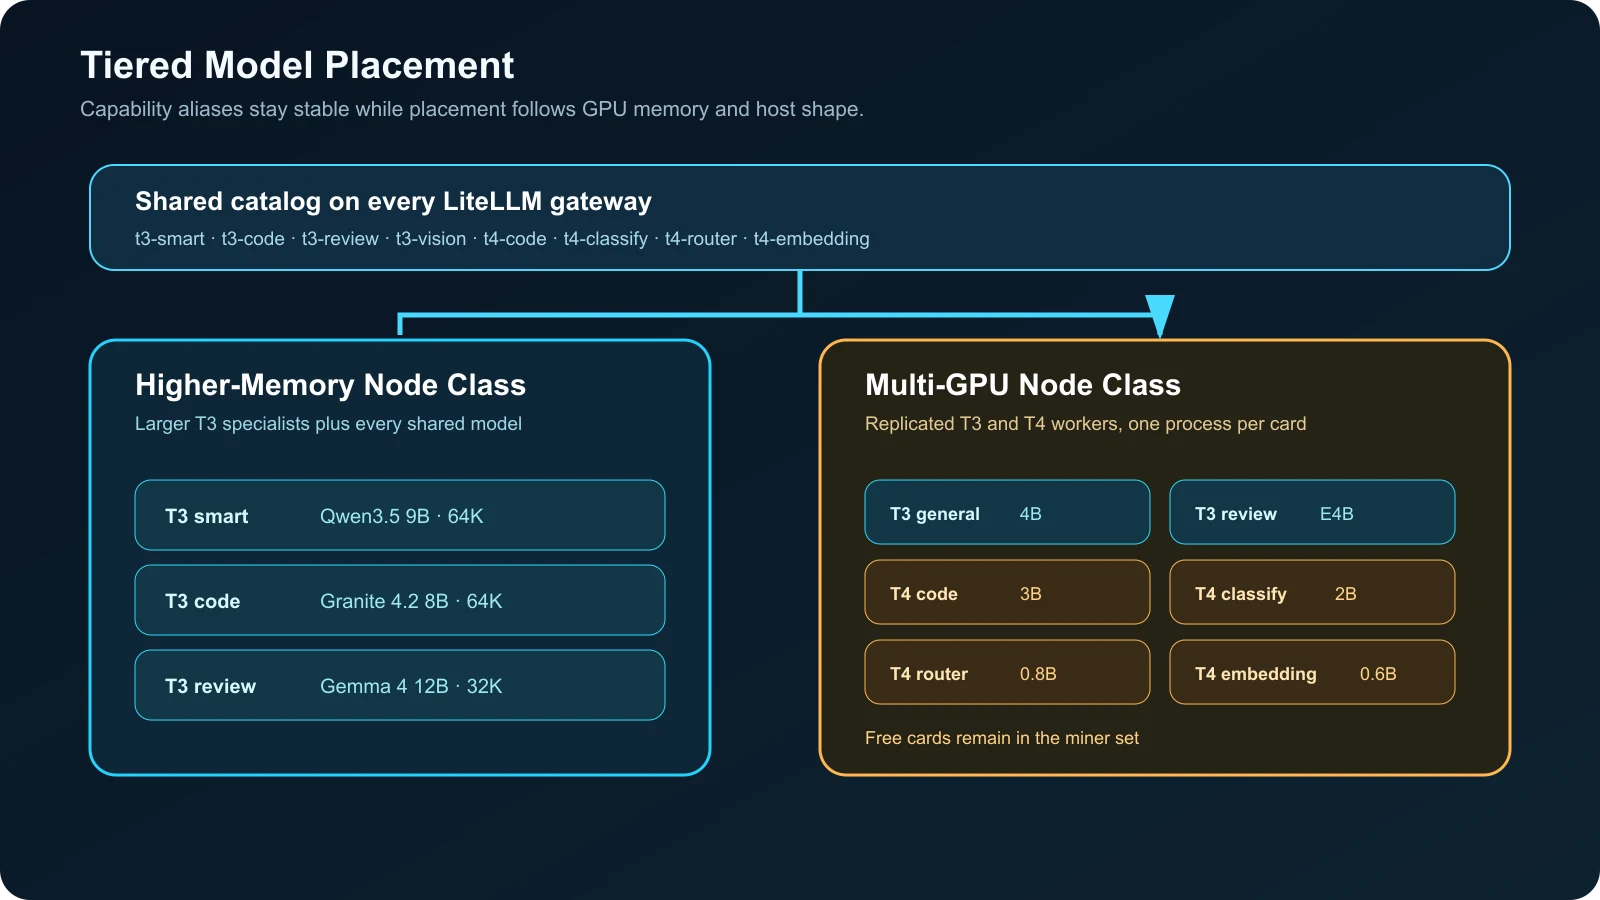
ਵੱਡੇ ਮਾਹਰ ਵੱਧ memory ਵਾਲੇ ਕਾਰਡਾਂ ਉੱਤੇ ਰਹਿੰਦੇ ਹਨ, ਜਦਕਿ ਛੋਟੇ ਮਾਹਰ ਪੂਰੇ ਫਲੀਟ ਵਿੱਚ ਦੁਹਰਾਏ ਜਾਂਦੇ ਹਨ
llama.cpp ਉਤਪਾਦਨ ਵਿੱਚ ਕਿਉਂ ਚੱਲਦਾ ਹੈ
llama.cpp ਸਰੋਤ ਮਾਡਲ ਨਾਲ ਮੇਲ ਖਾਂਦਾ ਹੈ। ਇੱਕ static worker ਇੱਕ GPU, ਇੱਕ model file, ਇੱਕ configured context ਅਤੇ ਇੱਕ lease ਨਾਲ ਜੁੜਿਆ ਹੈ। Process boundary startup, teardown, GPU visibility ਅਤੇ log ਦੀ ਜਾਂਚ ਆਸਾਨ ਕਰਦੀ ਹੈ।
ਇਸ ਦਾ server OpenAI-compatible chat, response ਅਤੇ embedding ਸੇਵਾ ਦਿੰਦਾ ਹੈ। ਇਹ parallel decoding ਅਤੇ continuous batching ਵੀ ਸਹਾਇਕ ਕਰਦਾ ਹੈ। ਮੌਜੂਦਾ server documentation multimodal support ਨੂੰ experimental ਦੱਸਦੀ ਹੈ। ਇਹ ਵਿਸ਼ੇਸ਼ਤਾਵਾਂ llama.cpp server ਦਸਤਾਵੇਜ਼ ਵਿੱਚ ਹਨ।
ਵੱਡੇ node ਉੱਤੇ Ollama compatibility ਰਸਤੇ ਵਜੋਂ ਉਪਲਬਧ ਰਹਿੰਦਾ ਹੈ। Memory ਕਾਫ਼ੀ ਹੋਵੇ ਤਾਂ Ollama ਇਕੱਠੇ ਮਾਡਲ load ਕਰ ਸਕਦਾ ਅਤੇ
Ollama ਦੇ ਆਮ ਸਵਾਲ
ਵਿੱਚ ਦੱਸੇ keep_alive: 0 ਨਾਲ ਤੁਰੰਤ unload ਕਰ ਸਕਦਾ ਹੈ। ਪ੍ਰਤੀ-ਕਾਰਡ production route ਲਈ Ollama ਨਹੀਂ ਚੁਣਿਆ ਕਿਉਂਕਿ static llama.cpp worker placement ਅਤੇ teardown ਉੱਤੇ ਵਧੇਰੇ ਸਖ਼ਤ control ਦਿੰਦੇ ਹਨ।
ਅਸੀਂ Strata ਵੀ ਵੇਖਿਆ। Strata ਵੱਡੇ Qwen mixture-of-experts ਮਾਡਲ ਨੂੰ GPU memory, system RAM ਅਤੇ storage ਵਿੱਚ ਫੈਲਾਉਣ ਲਈ ਹੈ। ਇਸ ਦੇ ਪ੍ਰਕਾਸ਼ਿਤ preset 32 GB ਸਾਂਝੀ memory ਤੋਂ ਸ਼ੁਰੂ ਹੁੰਦੇ ਹਨ, ਜਦਕਿ low-RAM mode ਘੱਟ ਸਮਰੱਥਾ ਦੇ ਬਦਲੇ ਗਤੀ ਘਟਾਉਂਦਾ ਹੈ। Strata ਕੋਡ ਭੰਡਾਰ ਵੇਖੋ। Strata ਵੱਖਰਾ ਟੀਚਾ ਪੂਰਾ ਕਰਦਾ ਹੈ: ਇੱਕ ਜਾਂ ਕਈ ਕਾਰਡਾਂ ਉੱਤੇ ਇੱਕ ਵੱਡਾ hybrid ਮਾਡਲ। ਸਾਡਾ ਫਲੀਟ 12B ਤੋਂ ਛੋਟੇ ਕਈ ਸੁਤੰਤਰ worker ਪਸੰਦ ਕਰਦਾ ਹੈ।
ਹਰ GPU ਲਈ ਮੰਗ ਅਨੁਸਾਰ ਲੋਡਿੰਗ
Lazy loading ਹਰ model worker ਉੱਤੇ ਲਾਗੂ ਹੁੰਦੀ ਹੈ। ਬੇਨਤੀਆਂ ਦੇ ਵਿਚਕਾਰ ਸਿਸਟਮ ਸਿਰਫ਼ gateway, pool proxy, watchdog ਅਤੇ miner ਸਰਗਰਮ ਰੱਖਦਾ ਹੈ।
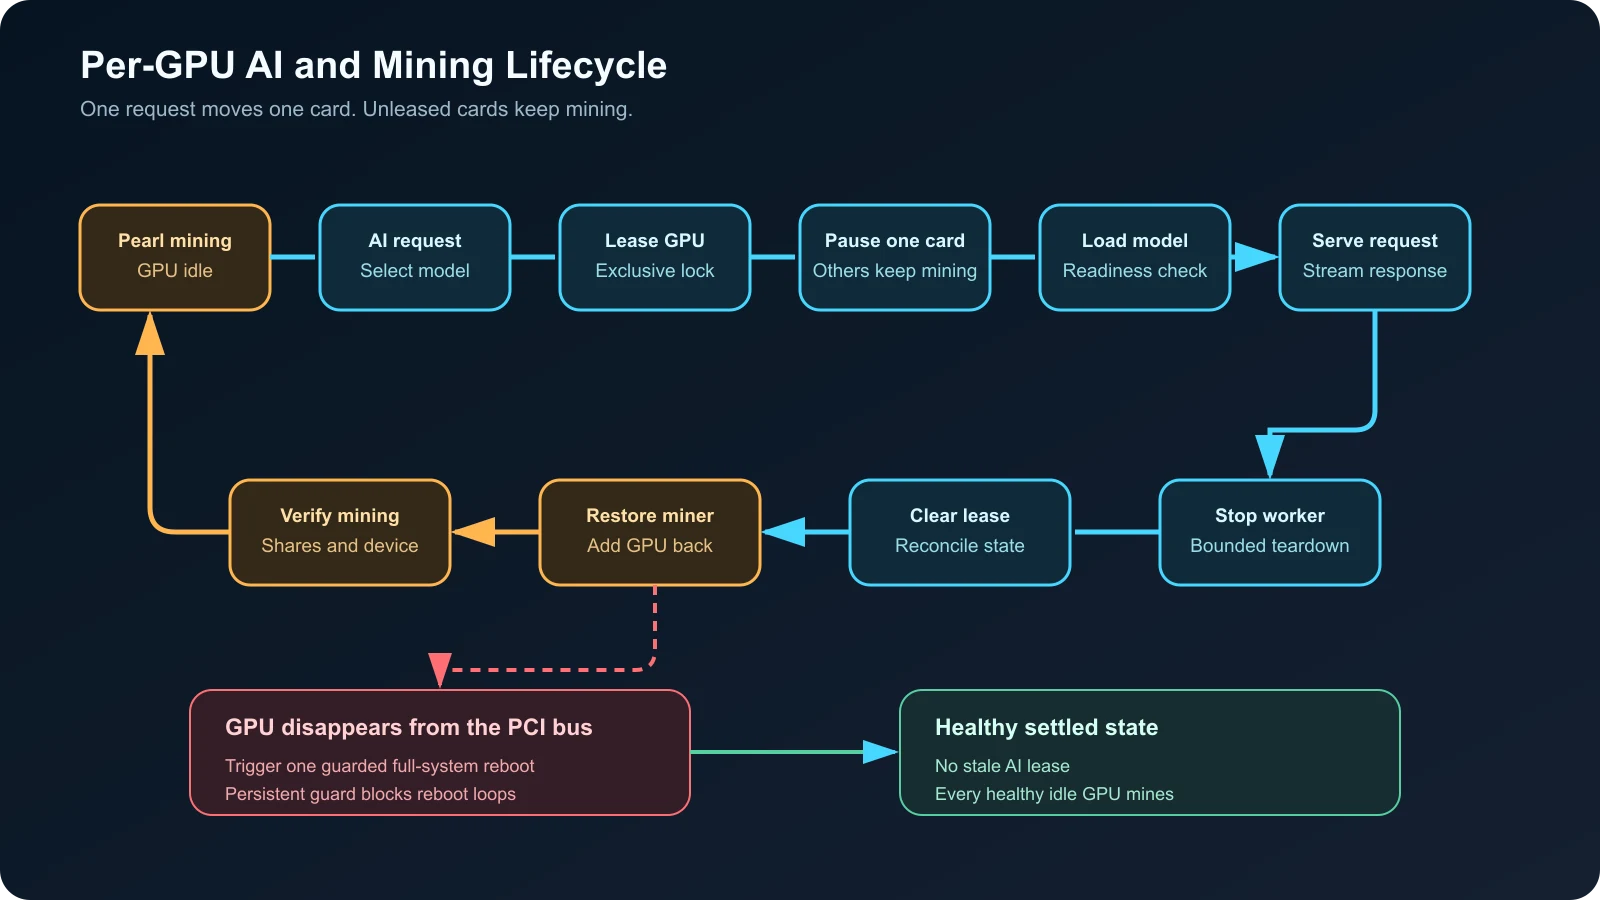
ਸਿਰਫ਼ ਕਿਰਾਏ ਉੱਤੇ ਲਿਆ ਕਾਰਡ miner ਛੱਡਦਾ ਅਤੇ model process ਮੁੱਕਣ ਮਗਰੋਂ ਵਾਪਸ ਆਉਂਦਾ ਹੈ
ਬੇਨਤੀ ਦਾ lifecycle ਇਹ ਕਦਮ ਲੈਂਦਾ ਹੈ:
- LiteLLM deployment ਚੁਣਦਾ ਹੈ। ਬੇਨਤੀ ਚੁਣੀ model class ਦੇ pool proxy ਕੋਲ ਜਾਂਦੀ ਹੈ।
- Pool lease ਲੈਂਦਾ ਹੈ। Lock ਦੋ exclusive worker ਨੂੰ ਇੱਕੋ ਕਾਰਡ ਲੈਣ ਤੋਂ ਰੋਕਦਾ ਹੈ।
- ਇੱਕ GPU ਤੋਂ ਬਿਨਾਂ miner ਮੁੜ ਚੱਲਦਾ ਹੈ। ਹਰ unleased ਕਾਰਡ Pearl command ਵਿੱਚ ਰਹਿੰਦਾ ਹੈ।
- ਕਿਰਾਏ ਵਾਲੇ device ਉੱਤੇ llama.cpp ਸ਼ੁਰੂ ਹੁੰਦਾ ਹੈ। Proxy ਵੱਲੋਂ ਬੇਨਤੀ ਭੇਜਣ ਤੋਂ ਪਹਿਲਾਂ readiness check ਪੂਰੇ ਹੁੰਦੇ ਹਨ।
- Worker ਜਵਾਬ ਸੇਵਾ ਕਰਦਾ ਹੈ। ਇੱਕੋ ਸਮੇਂ ਆਉਣ ਵਾਲੀਆਂ ਬੇਨਤੀਆਂ ਹੋਰ ਖਾਲੀ ਕਾਰਡਾਂ ਉੱਤੇ worker ਸ਼ੁਰੂ ਕਰਦੀਆਂ ਹਨ।
- Worker ਬੰਦ ਹੁੰਦਾ ਹੈ। Process teardown ਤੋਂ ਬਾਅਦ pool lease ਹਟਾਉਂਦਾ ਹੈ।
- ਖਾਲੀ ਹੋਏ GPU ਨਾਲ miner ਮੁੜ ਚੱਲਦਾ ਹੈ। Health check ਪੁਸ਼ਟੀ ਕਰਦਾ ਹੈ ਕਿ ਕਾਰਡ ਮਾਈਨਿੰਗ ਵਿੱਚ ਮੁੜ ਆ ਗਿਆ।
ਇਹ ਪੂਰੇ host ਨੂੰ ਇਕੱਠੇ ਬਦਲਣ ਤੋਂ ਵੱਖਰਾ ਹੈ। ਕਈ ਕਾਰਡਾਂ ਵਾਲਾ chassis ਕਈ ਮਾਡਲ ਸੇਵਾ ਦਿੰਦਾ ਹੈ ਅਤੇ ਬਾਕੀ ਕਾਰਡ ਮਾਈਨਿੰਗ ਕਰਦੇ ਰਹਿੰਦੇ ਹਨ। ਫਲੀਟ ਵਿਹਲਾ ਹੋਵੇ ਤਾਂ ਹਰ ਸਿਹਤਮੰਦ GPU Pearl ਕੋਲ ਵਾਪਸ ਜਾਂਦਾ ਹੈ।
Pearl ਸ਼ਵੇਤਪੱਤਰ ਇਸ ਦੇ matrix-computation proof system ਦਾ ਵੇਰਵਾ ਦਿੰਦਾ ਹੈ। ਸਾਡਾ architecture profitability forecast ਜਾਂ ਆਰਥਿਕ ਮੁਨਾਫ਼ੇ ਦੇ ਦਾਅਵੇ ਉੱਤੇ ਨਿਰਭਰ ਨਹੀਂ। ਮਾਈਨਿੰਗ ਵਿਹਲੇ ਸਮੇਂ ਲਈ ਸੈੱਟ ਕੀਤਾ workload ਹੈ।
ਸ਼ੁਰੂਆਤ ਨਾਲੋਂ ਨਾਕਾਮੀ ਸੰਭਾਲ ਵੱਧ ਮਹੱਤਵਪੂਰਨ ਹੈ
Model startup lifecycle ਦਾ ਅੱਧਾ ਹਿੱਸਾ ਹੈ। ਜ਼ਬਰਦਸਤੀ stop, GPU ਦਾ ਗਾਇਬ ਹੋਣਾ, ਬੇਨਤੀ ਰੁਕਣਾ, ਪੁਰਾਣਾ lease ਅਤੇ miner restart ਲਈ ਸਪਸ਼ਟ handling ਲੋੜੀਂਦੀ ਹੈ।
ਸਾਡਾ watchdog configured GPU set ਦੀ ਤੁਲਨਾ live NVIDIA device list ਨਾਲ ਕਰਦਾ ਹੈ। GPU ਦੀ ਗੈਰਹਾਜ਼ਰੀ ਪੱਕੀ ਹੋਣ ਉੱਤੇ ਇੱਕ guarded full-system reboot ਕਰਦਾ ਹੈ। ਸੁਰੱਖਿਅਤ production trigger ਵਿੱਚ ਵਾਰ-ਵਾਰ ਅਸਫਲ check, cooldown, active job drain, ਸਥਾਈ reboot counter ਅਤੇ remote alert ਹੋਣੇ ਚਾਹੀਦੇ ਹਨ। ਇੱਕ recovery ਅਸਫਲ ਹੋਵੇ ਤਾਂ automation ਰੁਕ ਕੇ ਹੱਥੀਂ ਦਖ਼ਲ ਮੰਗੇ।
ਉਹੀ watchdog ਪੁਰਾਣੇ lease ਵੀ ਮਿਲਾਉਂਦਾ ਹੈ। ਕੋਈ worker lease ਦਾ ਮਾਲਕ ਨਾ ਹੋਵੇ ਤਾਂ reconciliation ਪੁਰਾਣਾ record ਹਟਾ ਕੇ GPU miner ਨੂੰ ਵਾਪਸ ਕਰਦੀ ਹੈ। Broker canary ਦੌਰਾਨ ਇਹ recovery path ਕੰਮ ਆਇਆ।
| ਨਾਕਾਮੀ | ਜਵਾਬ |
|---|---|
| Model readiness check ਵਿੱਚ ਨਾਕਾਮ | Worker ਰੋਕੋ, lease ਛੱਡੋ, ਮਾਈਨਿੰਗ ਵਾਪਸ ਚਾਲੂ ਕਰੋ ਅਤੇ error ਦਿਓ |
| ਬੇਨਤੀ ਅਣਉਮੀਦੇ ਤੌਰ ਉੱਤੇ ਮੁੱਕੇ | Cleanup ਦਾ ਸਮਾਂ ਸੀਮਿਤ ਕਰੋ, worker process tree ਖਤਮ ਕਰੋ ਅਤੇ lease ਮਿਲਾਓ |
| GPU ਗਾਇਬ ਹੋਵੇ | ਵਾਰ-ਵਾਰ ਗੈਰਹਾਜ਼ਰੀ ਪੱਕੀ ਕਰੋ, ਸਰਗਰਮ ਕੰਮ ਰੋਕੋ, ਇੱਕ guarded reboot ਕਰੋ, alert ਭੇਜੋ ਅਤੇ ਫਿਰ ਪੂਰਾ configured GPU set ਜਾਂਚੋ |
| Miner ਵਿਹਲਾ ਕਾਰਡ ਛੱਡ ਦੇਵੇ | Active lease ਤੋਂ device list ਮੁੜ ਬਣਾਓ ਅਤੇ miner ਮੁੜ ਚਲਾਓ |
| LiteLLM deployment ਨਾਕਾਮ ਹੋਵੇ | ਉਸੇ model group ਵਿੱਚ ਹੋਰ replica ਉੱਤੇ retry ਕਰੋ, ਫਿਰ fallback policy ਮੰਨੋ |
| Aperture grant route ਰੋਕੇ | Identity ਜਾਂ model grant ਠੀਕ ਕਰੋ, gateway policy ਨੂੰ bypass ਨਾ ਕਰੋ |
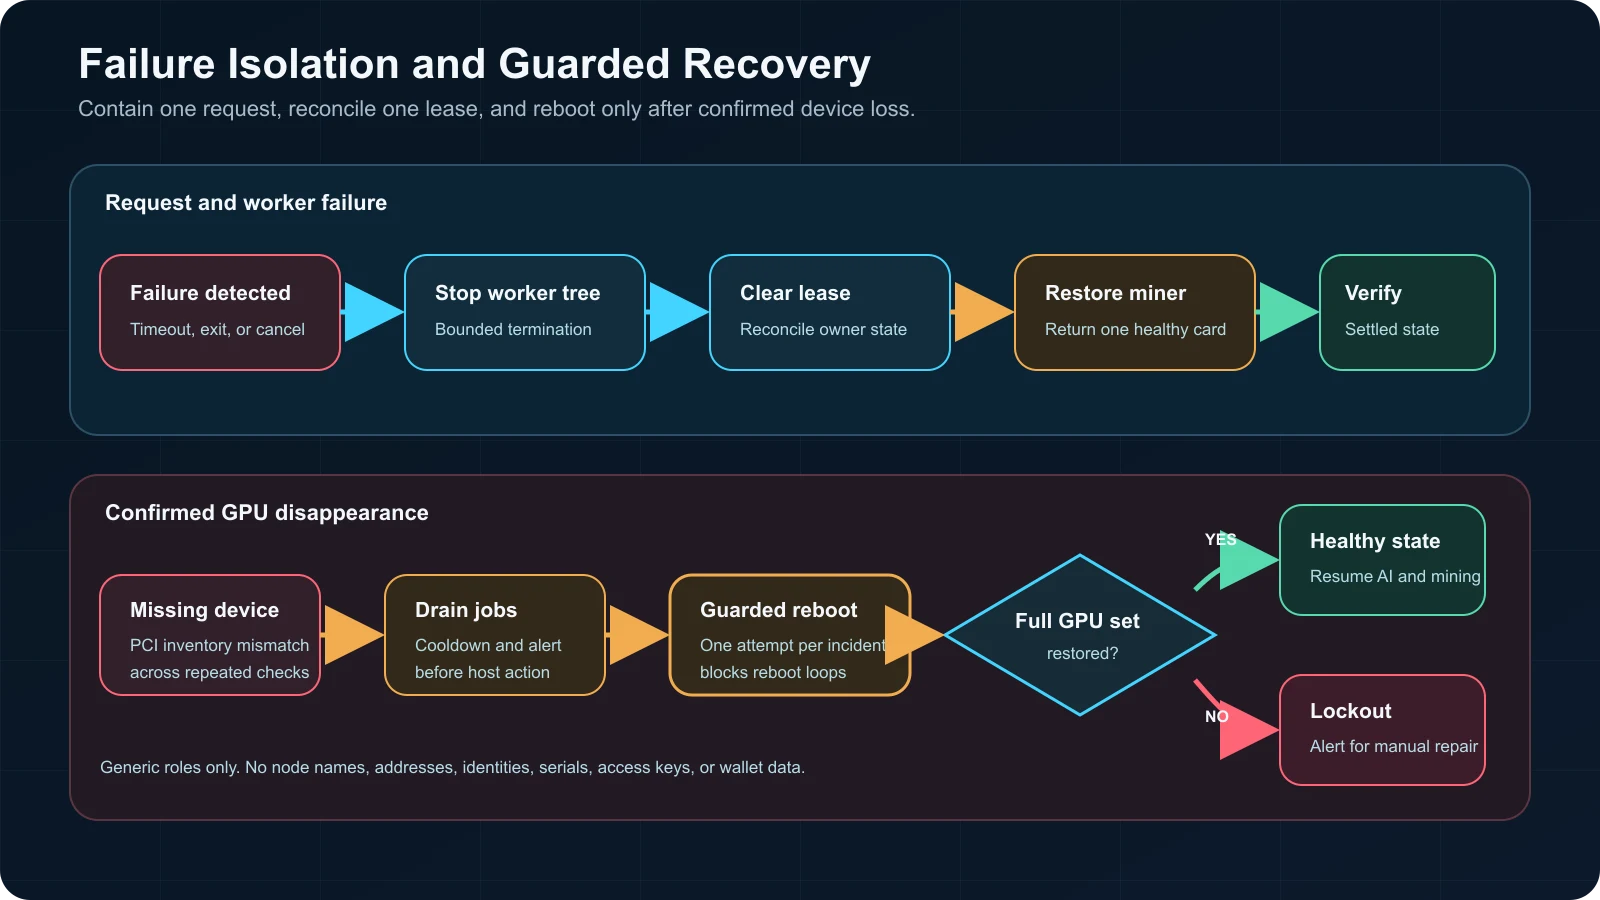
ਆਮ failure ਇੱਕ lease ਛੱਡਦਾ ਹੈ, ਜਦਕਿ ਪੱਕੀ device loss guarded host-recovery path ਚਾਲੂ ਕਰਦੀ ਹੈ
ਤਜਰਬਾਤੀ ਵਿਚੋਲੇ ਨਾਲ ਕੀ ਹੋਇਆ
ਬੈਕਐਂਡ-ਨਿਰਪੱਖ ਵਿਚੋਲਾ Ollama, vLLM, llama.cpp ਅਤੇ Strata ਲਈ ਇੱਕ OpenAI-compatible interface ਦੇਣਾ ਚਾਹੁੰਦਾ ਹੈ। ਇਸ ਵਿੱਚ ਹਰ ਮਾਡਲ ਦਾ lifecycle management, idle unload ਅਤੇ GPU placement ਹੈ।
ਅਸੀਂ 21 ਅਕਤੂਬਰ 2026 ਨੂੰ commit c12b65 ਉੱਤੇ broker version 0.6.0 ਦੀ ਜਾਂਚ ਕੀਤੀ। ਇਸ ਦੀ local suite ਨੇ 1,101 test pass ਅਤੇ 2 skip ਦੱਸੇ, Ruff ਸਾਫ਼ ਸੀ। Canary ਨੇ ਮੰਗ ਉੱਤੇ ਮਾਡਲ load ਕਰਕੇ ਸਫਲ chat request ਦਿੱਤੀ। ਬੇਨਤੀ ਦੌਰਾਨ ਬਾਕੀ GPU ਮਾਈਨਿੰਗ ਕਰਦੇ ਰਹੇ।
Shutdown ਵਿੱਚ lifecycle ਦੀ ਗੰਭੀਰ ਸਮੱਸਿਆ ਸਾਹਮਣੇ ਆਈ। Model load ਹੋਣ ਮਗਰੋਂ systemd ਵੱਲੋਂ process tree ਮਾਰਨ ਤੱਕ broker ਆਪਣੇ stop path ਵਿੱਚ ਫਸਿਆ ਰਿਹਾ। ਜ਼ਬਰਦਸਤੀ stop ਨੇ ਪੁਰਾਣਾ GPU lease ਛੱਡਿਆ, ਜਿਸ ਨੂੰ reconciliation ਨੇ miner ਵਾਪਸ ਲਿਆਉਣ ਤੱਕ ਠੀਕ ਕੀਤਾ। Documented required-GPU setting ਅਤੇ production adapter ਦੇ enforcement ਵਿਚਕਾਰ ਵੀ ਫ਼ਰਕ ਮਿਲਿਆ।
ਅਸੀਂ production path ਵਿੱਚ broker ਬੰਦ ਕਰ ਦਿੱਤਾ। LiteLLM ਹੁਣ ਹਰ ਬੇਨਤੀ ਲਈ pool proxy ਰਾਹੀਂ route ਕਰਦਾ ਹੈ। Child process ਦਾ bounded shutdown, process-group termination, required-GPU admission check ਅਤੇ ਪੁਰਾਣੇ lease ਦੀ ਸਫ਼ਾਈ integration test ਪਾਸ ਕਰਨ ਤੱਕ broker ਤਜਰਬਾਤੀ ਰਹੇਗਾ।
ਇਹ ਲਾਭਕਾਰੀ engineering ਸਿੱਖਿਆ ਹੈ। ਇੱਕ ਵਾਰ ਮਾਡਲ ਸ਼ੁਰੂ ਕਰ ਦੇਣਾ broker ਬਾਰੇ ਬਹੁਤ ਕੁਝ ਸਾਬਤ ਨਹੀਂ ਕਰਦਾ। Production readiness ਸਾਫ਼ teardown, ਸੀਮਿਤ ਸਮੇਂ ਦੀ recovery, exclusive device admission ਅਤੇ ਦੁਹਰਾਏ ਜਾ ਸਕਦੇ failure drill ਉੱਤੇ ਨਿਰਭਰ ਕਰਦੀ ਹੈ।
ਕੀਤੀ ਤਸਦੀਕ
Deployment test ਨੇ ਸਿਰਫ਼ model response ਤੋਂ ਵੱਧ ਜਾਂਚਿਆ:
- ਹਰ shared chat model ਨੇ ਘੱਟੋ-ਘੱਟ ਇੱਕ ਯੋਗ host ਉੱਤੇ load, answer, exit ਅਤੇ Pearl recovery cycle ਪੂਰਾ ਕੀਤਾ।
- Vision ਨੇ chat route ਰਾਹੀਂ image input ਸਵੀਕਾਰਿਆ।
- Embedding ਨੇ ਨਿੱਜੀ LiteLLM path ਰਾਹੀਂ configured vector size ਵਾਪਸ ਦਿੱਤਾ।
- ਵੱਖਰੇ ਕਾਰਡਾਂ ਉੱਤੇ ਕਈ model ਇੱਕੋ ਵੇਲੇ ਚੱਲੇ।
- ਇਕੱਠੀਆਂ AI ਬੇਨਤੀਆਂ ਦੌਰਾਨ unleased ਕਾਰਡ miner ਵਿੱਚ ਰਹੇ।
- Shared alias ਨੇ ਯੋਗ node ਵਿਚਕਾਰ ਬੇਨਤੀਆਂ route ਕੀਤੀਆਂ।
- Node-prefixed alias ਨੇ ਨਿਸ਼ਚਿਤ placement ਕਾਇਮ ਰੱਖੀ।
- ਹਰ LiteLLM gateway ਨੇ ਉਹੀ logical catalog ਦਿਖਾਇਆ।
- ਇੱਕ ਪੂਰੇ host reboot ਤੋਂ ਬਾਅਦ ਗਾਇਬ GPU ਮੁੜ ਆਇਆ। Watchdog ਵਿੱਚ ਹੁਣ persistent loop guard ਹੈ।
- Lease reconciliation ਰਾਹੀਂ broker shutdown failure ਠੀਕ ਹੋਇਆ।
- ਅਖੀਰਲੀ ਸਥਿਰ ਹਾਲਤ ਵਿੱਚ ਕੋਈ AI lease ਨਹੀਂ ਸੀ ਅਤੇ ਹਰ ਸਿਹਤਮੰਦ GPU miner set ਵਿੱਚ ਵਾਪਸ ਸੀ।
Health check ਅਤੇ model listing ਨੂੰ model-load test ਨਹੀਂ ਮੰਨਿਆ। ਲਾਭਕਾਰੀ acceptance test ਅਸਲ ਬੇਨਤੀ ਭੇਜਦੀ, ਜਵਾਬ ਜਾਂਚਦੀ, ਚੁਣੇ GPU ਦੀ ਪੁਸ਼ਟੀ ਕਰਦੀ, teardown ਵੇਖਦੀ ਅਤੇ ਮਾਈਨਿੰਗ ਦੀ ਵਾਪਸੀ ਤਸਦੀਕ ਕਰਦੀ ਹੈ।
ਫਲੀਟ ਦੀਆਂ ਸਮੱਸਿਆਵਾਂ ਹੱਲ ਕਰਨਾ
| ਲੱਛਣ | ਪਹਿਲੀ ਜਾਂਚ |
|---|---|
| ਮਾਡਲ ਦਿਖਦਾ ਹੈ ਪਰ ਬੇਨਤੀਆਂ ਨਾਕਾਮ ਹਨ | Upstream model ID, API format, auth header ਅਤੇ provider base URL |
| Aperture 405 ਵਾਪਸ ਕਰਦਾ ਹੈ | Provider root ਵਿੱਚ ਦੁਹਰਾਇਆ /v1 suffix ਤਾਂ ਨਹੀਂ |
| ਗਲਤ node ਬੇਨਤੀ ਸੇਵਾ ਕਰਦਾ ਹੈ | Shared alias ਜਾਂ node-prefixed alias |
| ਦੋ worker ਇੱਕੋ ਕਾਰਡ ਮੰਗਦੇ ਹਨ | Lease lock, ਪੁਰਾਣੀ lease state ਅਤੇ GPU admission logic |
| ਹਰ ਕਾਰਡ ਉੱਤੇ ਮਾਈਨਿੰਗ ਰੁਕਦੀ ਹੈ | Miner restart code active lease ਤੋਂ device list ਬਣਾਉਂਦਾ ਹੈ ਕਿ ਨਹੀਂ |
| GPU ਮਾਈਨਿੰਗ ਵਿੱਚ ਵਾਪਸ ਨਹੀਂ ਆਉਂਦਾ | Worker process tree, lease reconciliation ਅਤੇ miner device list |
| Cold load ਹੌਲੀ ਹੈ | Model size, storage speed, PCIe link width ਅਤੇ host CPU pressure |
| ਲੰਮੇ prompt ਨਾਕਾਮ ਹੁੰਦੇ ਹਨ | Configured context, KV cache headroom ਅਤੇ output reservation |
| Aperture ਵਿੱਚ embedding route ਨਹੀਂ | Tailscale identity ਅਤੇ host firewall policy ਨਾਲ ਸੀਮਿਤ authenticated LiteLLM route ਵਰਤੋ |
| Broker stop ਫਸ ਜਾਂਦਾ ਹੈ | Broker route ਬੰਦ ਕਰਕੇ traffic ਤਸਦੀਕਸ਼ੁਦਾ pool proxy ਵੱਲ ਮੋੜੋ |
ਰੱਖਣ ਯੋਗ ਡਿਜ਼ਾਈਨ ਨਿਯਮ
- ਕੰਮ ਦੇ ਮਕਸਦ ਅਨੁਸਾਰ route ਕਰੋ। ਸਿਰਫ਼ model size tier ਤੈਅ ਨਹੀਂ ਕਰਦਾ।
- Placement ਤੋਂ ਉੱਪਰ policy ਰੱਖੋ। Hermes capability alias ਚੁਣਦਾ ਹੈ। LiteLLM deployment ਚੁਣਦਾ ਹੈ। Pool GPU ਚੁਣਦਾ ਹੈ।
- ਹਰ GPU ਨੂੰ ਵੱਖਰਾ lease ਮੰਨੋ। ਪੂਰੇ host ਨੂੰ ਬਦਲਣ ਨਾਲ ਉਪਲਬਧ ਕਾਰਡ ਵਿਅਰਥ ਜਾਂਦੇ ਹਨ।
- ਹਰ idle model unload ਕਰੋ। ਚੱਲਦੇ gateway ਨੂੰ ਚੱਲਦੇ GPU worker ਦੀ ਲੋੜ ਨਹੀਂ।
- ਸੀਮਿਤ exact-placement path ਰੱਖੋ। ਸਿਰਫ਼ operator ਲਈ node alias diagnostic ਦੁਹਰਾਉਣ ਯੋਗ ਬਣਾਉਂਦੇ ਹਨ।
- Teardown ਪਹਿਲਾਂ ਜਾਂਚੋ। Miner recovery ਅਤੇ lease cleanup acceptance test ਦਾ ਹਿੱਸਾ ਹਨ।
- Chat, vision ਅਤੇ embedding ਵੱਖ ਰੱਖੋ। ਇੱਕ gateway ਦਾ ਮਤਲਬ ਇੱਕ protocol path ਨਹੀਂ।
- ਚਿੱਤਰਾਂ ਤੋਂ ਨਿੱਜੀ ਵੇਰਵੇ ਬਾਹਰ ਰੱਖੋ। Address, key, identity ਜਾਂ wallet data ਨਹੀਂ, role ਅਤੇ flow ਦਿਖਾਓ।
- Reboot logic ਉੱਤੇ guard ਲਗਾਓ। ਵਾਰ-ਵਾਰ ਗੈਰਹਾਜ਼ਰੀ, cooldown, ਸਥਾਈ counter, alert ਅਤੇ recovery ਫੇਲ੍ਹ ਹੋਣ ਉੱਤੇ ਹੱਥੀਂ ਦਖ਼ਲ ਲਾਜ਼ਮੀ ਕਰੋ।
- ਤਜਰਬਾਤੀ bypass ਰੱਖੋ। Broker ਦੀ ਨਾਕਾਮੀ ਨਾਲ ਤਸਦੀਕਸ਼ੁਦਾ route ਵੀ ਨਹੀਂ ਡਿੱਗਣਾ ਚਾਹੀਦਾ।
ਅਗਲੇ ਕਦਮ
ਅਗਲਾ ਪੜਾਅ workload evaluation ਹੈ। ਹਰ tier ਲਈ ਨਿਸ਼ਚਿਤ task set, acceptance criteria, latency record, GPU occupancy, mining interruption time ਅਤੇ escalation rate ਚਾਹੀਦੀ ਹੈ। ਇਹ ਮਾਪ ਦੱਸਣਗੇ ਕਿ ਕਿਹੜੇ T2 ਕੰਮ T3 ਵਿੱਚ ਆਉਂਦੇ ਹਨ ਅਤੇ ਕਿਹੜੇ T3 ਕੰਮ T4 ਵਿੱਚ ਫਿੱਟ ਹੁੰਦੇ ਹਨ।
ਅਸੀਂ Hermes ਰਾਹੀਂ Aperture ਅਤੇ ਫਿਰ LiteLLM ਤੱਕ ਪਹਿਲਾ acceptance test ਚਲਾਉਣ ਦੀ ਯੋਜਨਾ ਵੀ ਬਣਾਉਂਦੇ ਹਾਂ। ਇਸ ਤੋਂ ਬਾਅਦ shutdown ਅਤੇ GPU admission path ਠੀਕ ਕਰਕੇ broker ਨੂੰ ਮੁੜ ਪਰਖਾਂਗੇ। ਉਸੇ routing catalog ਵਿੱਚ ਆਉਣ ਤੋਂ ਪਹਿਲਾਂ image generation ਲਈ ਆਪਣਾ lazy OpenAI-compatible adapter ਲੋੜੀਂਦਾ ਹੈ।
Model size ਲਈ ਸਥਾਨਕ AI ਮਾਡਲ ਅਤੇ GPU context guide ਪੜ੍ਹੋ। Privacy boundary ਲਈ ਸਥਾਨਕ AI privacy ਅਤੇ security ਪੜ੍ਹੋ। Miner setup ਅਤੇ ਖ਼ਤਰੇ ਲਈ Pearl ਮਾਈਨਿੰਗ ਮਾਰਗਦਰਸ਼ਿਕਾ ਵੇਖੋ, ਵਿਹਲੀ ਮਾਈਨਿੰਗ ਨੂੰ ਪੱਕਾ ਮੁਨਾਫ਼ਾ ਨਾ ਸਮਝੋ।
Related Posts