ਕੀ ਗੰਭੀਰ ਲੋਕਲ LLM ਕੰਮ ਲਈ 16GB VRAM ਕਾਫ਼ੀ ਹੈ?
Table of Contents
16GB ਦੀ ਸਮਰਪਿਤ GPU ਮੈਮੋਰੀ ਗੰਭੀਰ ਲੋਕਲ LLM ਕੰਮ ਲਈ ਕਾਫ਼ੀ ਹੈ, ਜਦੋਂ ਮਾਡਲ, ਕੌਂਟੈਕਸਟ ਅਤੇ ਰਨਟਾਈਮ ਇਕੱਠੇ ਫਿੱਟ ਹੋਣ। ਵਜ਼ਨ ਲੋਡ ਹੋਣਾ ਸਿਰਫ਼ ਪਹਿਲੀ ਲੋੜ ਪੂਰੀ ਕਰਦਾ ਹੈ। ਵਰਤੋਂਯੋਗ ਸੈਟਅੱਪ ਨੂੰ ਚੱਲ ਰਹੀ ਗੱਲਬਾਤ ਲਈ ਮੈਮੋਰੀ ਅਤੇ ਕੰਮ ਪੂਰਾ ਕਰਨ ਲਈ ਕਾਫ਼ੀ ਗਤੀ ਵੀ ਚਾਹੀਦੀ ਹੈ।
ਇੱਕ ਯੂਜ਼ਰ ਦੇ ਕੋਡਿੰਗ ਜਾਂ ਦਸਤਾਵੇਜ਼ ਵਰਕਫਲੋ ਦਾ ਬਜਟ ਬਣਾਉਣ ਲਈ Qwen3.8 27B ਨੂੰ ਉਦਾਹਰਨ ਵਜੋਂ ਵਰਤੋ। ਪਹਿਲਾਂ ਕੰਮ ਲਈ ਲੋੜੀਂਦਾ ਕੌਂਟੈਕਸਟ ਚੁਣੋ, ਫਿਰ ਬਾਕੀ ਮੈਮੋਰੀ ਵਿੱਚ ਫਿੱਟ ਵਜ਼ਨ ਅਤੇ ਰਨਟਾਈਮ ਸੈਟਿੰਗਾਂ ਚੁਣੋ। ਹਾਰਡਵੇਅਰ ਸਪੈਸਿਫਿਕੇਸ਼ਨ ਅਤੇ ਮਾਡਲ ਸਰੋਤ 7 ਅਕਤੂਬਰ 2026 ਨੂੰ ਜਾਂਚੇ ਗਏ ਸਨ।
ਮੁੱਖ ਗੱਲਾਂ
- ਕਵਾਂਟਾਈਜ਼ੇਸ਼ਨ ਚੁਣਨ ਤੋਂ ਪਹਿਲਾਂ ਕੌਂਟੈਕਸਟ ਲਈ ਮੈਮੋਰੀ ਰੱਖੋ।
- ਪ੍ਰੌਂਪਟ ਪ੍ਰੋਸੈਸਿੰਗ ਨੂੰ ਆਉਟਪੁੱਟ ਸਪੀਡ ਤੋਂ ਵੱਖਰਾ ਮਾਪੋ।
- ਨਾ ਵਰਤੇ ਵਿਜ਼ਨ ਸਪੋਰਟ ਨੂੰ ਬੰਦ ਕਰੋ ਅਤੇ 8-ਬਿਟ KV ਕੈਸ਼ ਟੈਸਟ ਕਰੋ।
- ਬਿਲਕੁਲ ਉਸੇ GPU, ਬੈਕਐਂਡ, ਮਾਡਲ ਫਾਈਲ ਅਤੇ ਪ੍ਰੌਂਪਟ ਲੰਬਾਈ ਦੀ ਤੁਲਨਾ ਕਰੋ।
- ਆਪਣੇ ਵਰਕਲੋਡ ਅਤੇ ਪ੍ਰੋਵਾਈਡਰ ਬਿੱਲ ਦੇ ਆਧਾਰ ਤੇ ਮਾਲਕੀ ਬਚਤ ਕੱਢੋ।
ਬਜਟ ਅਭਿਆਸ ਲਈ ਰਨਟਾਈਮ ਦਾ ਮੈਮੋਰੀ ਲੌਗ, ਮਾਡਲ ਫਾਈਲ ਦਾ ਸਹੀ ਨਾਮ ਅਤੇ ਇੱਕ ਪ੍ਰਤੀਨਿਧੀ ਕੰਮ ਚਾਹੀਦਾ ਹੈ। ਸੈਟਅੱਪ ਅਤੇ ਨਤੀਜੇ ਲਿਖਣ ਲਈ ਲਗਭਗ 20 ਮਿੰਟ ਰੱਖੋ, ਇਨਫਰੈਂਸ ਸਮਾਂ ਵੱਖਰਾ ਹੈ। ਮੁਸ਼ਕਲ ਪੱਧਰ ਦਰਮਿਆਨਾ ਹੈ।
ਮੈਮੋਰੀ ਨੂੰ ਕੰਮ ਨਾਲ ਮਿਲਾਓ
16GB ਉਸ ਵਰਕਲੋਡ ਲਈ ਢੁਕਵੀਂ ਹੈ ਜਿਸ ਵਿੱਚ ਵਜ਼ਨ, ਸਰਗਰਮ ਕੌਂਟੈਕਸਟ ਅਤੇ ਅਸਥਾਈ ਅਲੋਕੇਸ਼ਨ ਉਪਲਬਧ GPU ਮੈਮੋਰੀ ਵਿੱਚ ਰਹਿਣ। ਲੋੜੀਂਦਾ ਕੌਂਟੈਕਸਟ ਕੰਮ ਉੱਤੇ ਨਿਰਭਰ ਕਰਦਾ ਹੈ। ਛੋਟਾ ਦਸਤਾਵੇਜ਼ ਸਾਰ ਅਤੇ ਦਰਜਨਾਂ ਫਾਈਲਾਂ ਪੜ੍ਹਨ ਵਾਲੇ ਕੋਡਿੰਗ ਏਜੰਟ ਲਈ ਵੱਖਰੇ ਬਜਟ ਚਾਹੀਦੇ ਹਨ।
| ਵਰਕਲੋਡ | ਪਹਿਲਾ ਆਕਾਰ-ਨਿਰਧਾਰਣ ਸਵਾਲ |
|---|---|
| ਛੋਟੀ ਚੈਟ ਜਾਂ ਡ੍ਰਾਫਟਿੰਗ | ਕੀ ਮਾਡਲ ਤੁਹਾਡਾ ਗੁਣਵੱਤਾ ਟੀਚਾ ਪੂਰਾ ਕਰਦਾ ਹੈ? |
| ਦਸਤਾਵੇਜ਼ ਵਿਸ਼ਲੇਸ਼ਣ | ਕੀ ਸਰੋਤ ਟੈਕਸਟ ਅਤੇ ਜਵਾਬ ਇਕੱਠੇ ਫਿੱਟ ਹੁੰਦੇ ਹਨ? |
| ਕੋਡਿੰਗ ਏਜੰਟ | ਫਾਈਲਾਂ ਅਤੇ ਟੂਲ ਨਤੀਜੇ ਕਿੰਨਾ ਕੌਂਟੈਕਸਟ ਲੈਂਦੇ ਹਨ? |
| ਇਕੱਠੀਆਂ ਬੇਨਤੀਆਂ | ਹਰ ਸਰਗਰਮ ਸੈਸ਼ਨ ਨੂੰ ਕਿੰਨਾ ਕੈਸ਼ ਚਾਹੀਦਾ ਹੈ? |
ਕੌਂਫਿਗਰ ਕੀਤੀ ਵਿੰਡੋ ਅਤੇ ਵਰਤੀ ਵਿੰਡੋ ਵੱਖਰੀ ਹੁੰਦੀ ਹੈ। 64K ਸੀਮਾ ਅਤੇ ਛੋਟੇ ਪ੍ਰੌਂਪਟ ਵਾਲਾ ਬੈਂਚਮਾਰਕ 55K ਟੋਕਨ ਗੱਲਬਾਤ ਤੋਂ ਬਾਅਦ ਦੀ ਜਨਰੇਸ਼ਨ ਨਹੀਂ ਮਾਪਦਾ। ਹਾਰਡਵੇਅਰ ਚੁਣਨ ਤੋਂ ਪਹਿਲਾਂ ਉਮੀਦ ਕੀਤੀ ਸੈਸ਼ਨ ਲੰਬਾਈ ਦੇ ਨੇੜੇ ਟੈਸਟ ਕਰੋ।
ਮਾਡਲ ਕਿਉਂ ਫਿੱਟ ਹੁੰਦਾ ਹੈ
ਕਵਾਂਟਾਈਜ਼ੇਸ਼ਨ ਵਜ਼ਨਾਂ ਨੂੰ ਘੱਟ ਬਿਟਾਂ ਨਾਲ ਸਟੋਰ ਕਰਦੀ ਹੈ। Bartowski ਦੀ Qwen3.8 27B ਫਾਈਲ ਸੂਚੀ Q4_K_M ਲਈ 17.44 GB ਦੱਸਦੀ ਹੈ। ਰਨਟਾਈਮ ਮੈਮੋਰੀ ਤੋਂ ਪਹਿਲਾਂ ਹੀ ਇਹ 16 GiB ਡਿਵਾਈਸ ਦੇ ਲਗਭਗ 17.18 ਬਿਲੀਅਨ ਬਾਈਟ ਤੋਂ ਵੱਧ ਹੈ।
ISTA-DASLab ਦਾ GSQ-RCO ਮਾਡਲ ਕਾਰਡ IQ3_S ਲਈ 11.8 GB ਦੱਸਦਾ ਹੈ। ਇਹ ਵਿਧੀ ਆਕਾਰ ਬਜਟ ਵਿੱਚ ਵੱਖਰੇ ਟੈਂਸਰਾਂ ਨੂੰ ਵੱਖਰੀ ਸ਼ੁੱਧਤਾ ਦਿੰਦੀ ਹੈ। ਵਿਕਲਪਿਕ MTP ਵਰਜਨ ਲਗਭਗ 0.35 GB ਜੋੜਦਾ ਹੈ ਅਤੇ ਵਿਜ਼ਨ ਪ੍ਰੋਜੈਕਟਰ ਲਗਭਗ 0.9 GB ਜੋੜਦਾ ਹੈ।
| ਪ੍ਰਕਾਸ਼ਿਤ ਬੈਂਚਮਾਰਕ | BF16 / IQ3_S ਸਕੋਰ |
|---|---|
| AIME25 | 100.00 / 100.00 |
| LiveCodeBench v6 | 85.71 / 85.71 |
| GPQA-Diamond | 89.90 / 89.39 |
ਲੈਬ ਇਸ ਓਪਰੇਟਿੰਗ ਪੁਆਇੰਟ ਨੂੰ “task-lossless” ਕਹਿੰਦੀ ਹੈ। ਇਹ ਨਤੀਜੇ ਸੀਮਤ ਤੁਲਨਾ ਨੂੰ ਸਹਾਰਾ ਦਿੰਦੇ ਹਨ। ਇਹ ਇਕੋ ਜਵਾਬ, ਇਕੋ ਲੰਬੇ ਕੌਂਟੈਕਸਟ ਰਿਟਰੀਵਲ ਜਾਂ ਤੁਹਾਡੇ ਕੋਡਿੰਗ ਕੰਮਾਂ ਵਿੱਚ ਇਕੋ ਭਰੋਸੇਯੋਗਤਾ ਸਾਬਤ ਨਹੀਂ ਕਰਦੇ। ਕੰਪ੍ਰੈੱਸਡ ਮਾਡਲ ਨੂੰ ਆਪਣੇ ਸਵੀਕ੍ਰਿਤੀ ਮਾਪਦੰਡਾਂ ਨਾਲ ਟੈਸਟ ਕਰੋ।
ਕੈਸ਼ ਗਿਣੋ
KV ਕੈਸ਼ ਪਹਿਲਾਂ ਪ੍ਰੋਸੈਸ ਹੋਏ ਟੋਕਨਾਂ ਦੀਆਂ attention keys ਅਤੇ values ਰੱਖਦਾ ਹੈ। ਪ੍ਰੌਂਪਟ, ਟੂਲ ਆਉਟਪੁੱਟ ਅਤੇ ਜਨਰੇਟ ਕੀਤੇ ਜਵਾਬ ਕੌਂਟੈਕਸਟ ਲੈਂਦੇ ਹਨ। ਕੁਝ ਰਨਟਾਈਮ ਸ਼ੁਰੂ ਵੇਲੇ ਕੈਸ਼ ਸਮਰੱਥਾ ਅਲੋਕੇਟ ਕਰਦੇ ਹਨ, ਇਸ ਲਈ ਦਿਖਾਈ ਮੈਮੋਰੀ ਹਰ ਸੁਨੇਹੇ ਨਾਲ ਵਧਣੀ ਲਾਜ਼ਮੀ ਨਹੀਂ।
Qwen ਕੌਂਫਿਗਰੇਸ਼ਨ 64 ਲੇਅਰ, ਹਰ ਚੌਥੀ ਲੇਅਰ ਉੱਤੇ full attention, ਚਾਰ KV heads ਅਤੇ 256 head dimension ਦਿੰਦੀ ਹੈ। ਉਹਨਾਂ 16 full-attention ਲੇਅਰਾਂ ਲਈ FP16 ਕੈਸ਼ ਲਾਗਤ ਇਹ ਹੈ:
16 layers × 4 KV heads × 256 elements × 2 (K and V) × 2 bytes
= 65,536 bytes per token
= 64 KiB per token
ਇਸ ਗਣਨਾ ਵਿੱਚ recurrent state, alignment, temporary buffers ਅਤੇ speculative decoding allocations ਸ਼ਾਮਲ ਨਹੀਂ ਹਨ। ਹੋਰ architectures ਲਈ ਵੱਖਰੀ ਗਣਨਾ ਚਾਹੀਦੀ ਹੈ।
| ਵਰਤੇ ਟੋਕਨ | FP16 full-attention cache |
|---|---|
| 32,768 | 2 GiB |
| 65,536 | 4 GiB |
| 131,072 | 8 GiB |
| 262,144 | 16 GiB |
ਇੱਥੇ KiB ਅਤੇ GiB 1024 ਦੀਆਂ ਘਾਤਾਂ ਵਰਤਦੇ ਹਨ। ਮਾਡਲ ਡਾਊਨਲੋਡ ਆਕਾਰ decimal GB ਵਿੱਚ ਹਨ। ਯੂਨਿਟ ਮਿਲਾਉਣ ਨਾਲ ਬਾਕੀ ਬਜਟ ਗਲਤ ਦਿਖਦਾ ਹੈ।
ਉਪਲਬਧ ਕੌਂਟੈਕਸਟ ਦਾ ਬਜਟ ਬਣਾਓ
ਦੋ ਸੈਟਿੰਗਾਂ ਲੰਬੇ ਟੈਕਸਟ ਸੈਸ਼ਨਾਂ ਲਈ ਮੈਮੋਰੀ ਖਾਲੀ ਕਰਦੀਆਂ ਹਨ। ਨਾ ਵਰਤਿਆ ਵਿਜ਼ਨ ਪ੍ਰੋਜੈਕਟਰ ਹਟਾਓ ਅਤੇ ਕੈਸ਼ ਦੀ ਸ਼ੁੱਧਤਾ ਘਟਾਓ। ਆਪਣੀ ਲੋਡ ਕੀਤੀ ਮਾਡਲ ਅਤੇ ਰਨਟਾਈਮ ਅਲੋਕੇਸ਼ਨਾਂ ਦੇ ਮੁਕਾਬਲੇ ਪ੍ਰਭਾਵ ਗਿਣੋ।
ਇਸ ਉਦਾਹਰਨ ਵਿੱਚ ਸਾਰੀਆਂ ਅਲੋਕੇਸ਼ਨਾਂ decimal GB ਵਿੱਚ ਹਨ। ਹੇਠਾਂ ਦਿੱਤਾ 1.0 GB ਰਿਜ਼ਰਵ ਯੋਜਨਾ ਦਾ ਅਨੁਮਾਨ ਹੈ, ਯੂਨੀਵਰਸਲ ਰਨਟਾਈਮ ਡਿਫਾਲਟ ਨਹੀਂ।
| ਅਲੋਕੇਸ਼ਨ | ਵਿਜ਼ਨ ਚਾਲੂ / ਬੰਦ |
|---|---|
| ਭੌਤਿਕ 16 GiB ਸਮਰੱਥਾ | 17.180 / 17.180 GB |
| ਮਾਡਲ ਵਜ਼ਨ | 11.800 / 11.800 GB |
| ਵਿਕਲਪਿਕ MTP head | 0.350 / 0.350 GB |
| ਵਿਜ਼ਨ ਪ੍ਰੋਜੈਕਟਰ ਅਨੁਮਾਨ | 0.930 / 0 GB |
| ਮੰਨੀਆਂ ਹੋਰ ਅਲੋਕੇਸ਼ਨਾਂ | 1.000 / 1.000 GB |
| ਵਧਦੇ ਕੈਸ਼ ਲਈ ਬਾਕੀ | 3.100 / 4.030 GB |
65,536 bytes ਪ੍ਰਤੀ ਟੋਕਨ ਉੱਤੇ 3.100 GB ਲਗਭਗ 47,300 ਟੋਕਨ ਰੱਖਦਾ ਹੈ। ਆਦਰਸ਼ 8-bit storage ਵਿੱਚ 32,768 bytes ਪ੍ਰਤੀ ਟੋਕਨ ਲੱਗਦੇ ਅਤੇ ਵਿਜ਼ਨ ਬੰਦ ਹੋਣ ਤੇ ਲਗਭਗ 123,000 ਟੋਕਨ ਆਉਂਦੇ।
ਅਸਲ q8_0 storage ਵਿੱਚ block scales ਹੁੰਦੇ ਹਨ। 32 values ਲਈ 34 bytes ਉੱਤੇ ਇਹ ਉਦਾਹਰਨ ਲਗਭਗ 34,816 bytes ਪ੍ਰਤੀ ਟੋਕਨ ਮੰਗਦੀ ਹੈ, ਜਿਸ ਨਾਲ ਅਨੁਮਾਨ ਲਗਭਗ 115,700 ਰਹਿ ਜਾਂਦਾ ਹੈ। ਵਾਧੂ ਅਲੋਕੇਸ਼ਨਾਂ ਨਾਲ ਨਤੀਜਾ ਹੋਰ ਘਟੇਗਾ। ਇਸ ਲਈ ਇਹਨਾਂ ਧਾਰਣਾਂ ਵਿੱਚ ਲਗਭਗ 110K ਯੋਜਨਾ ਲਈ ਸੰਭਵ ਨਤੀਜਾ ਹੈ, ਗਾਰੰਟੀਸ਼ੁਦਾ ਸੈਟਿੰਗ ਨਹੀਂ।
ਬਾਕੀ ਕੌਂਟੈਕਸਟ ਵਿੱਚ input ਅਤੇ output ਦੋਵੇਂ ਆਉਣੇ ਹਨ। 65,536-token ਵਿੰਡੋ ਵਿੱਚ 30,000-token ਦਾ ਉਦਾਹਰਨ initial prompt ਅਤੇ 8,192-token output allowance, ਫਾਈਲਾਂ, ਟੂਲ ਨਤੀਜਿਆਂ ਅਤੇ ਗੱਲਬਾਤ ਲਈ 27,344 ਟੋਕਨ ਛੱਡਦੇ ਹਨ। Initial prompt budget ਸਿਰਫ਼ ਉਦਾਹਰਨ ਹੈ। ਆਪਣੇ tools ਅਤੇ instructions ਮਾਪੋ।
ਟੈਸਟ ਕਰਨ ਯੋਗ ਸੈਟਿੰਗਾਂ
llama.cpp server documentation key ਅਤੇ value cache types, automatic projector loading ਅਤੇ parallel slots ਦੱਸਦੀ ਹੈ। text-only workload ਲਈ vision ਬੰਦ, ਦੋਵੇਂ cache types ਲਈ q8_0 ਅਤੇ ਇੱਕ slot ਟੈਸਟ ਕਰੋ। ਪਹਿਲਾਂ ਮੱਧਮ context ਵਰਤੋ।
ਕੌਂਟੈਕਸਟ ਵਧਾਉਣ ਤੋਂ ਪਹਿਲਾਂ ਅਲੋਕੇਸ਼ਨਾਂ ਲਿਖੋ। Cache quantization ਲਈ ਚੁਣੀ architecture ਅਤੇ backend ਦਾ support ਚਾਹੀਦਾ ਹੈ। Precision ਬਦਲਣ ਤੋਂ ਬਾਅਦ answer quality ਟੈਸਟ ਕਰੋ। ਤੁਲਨਾ ਲਈ working configuration ਰੱਖੋ।
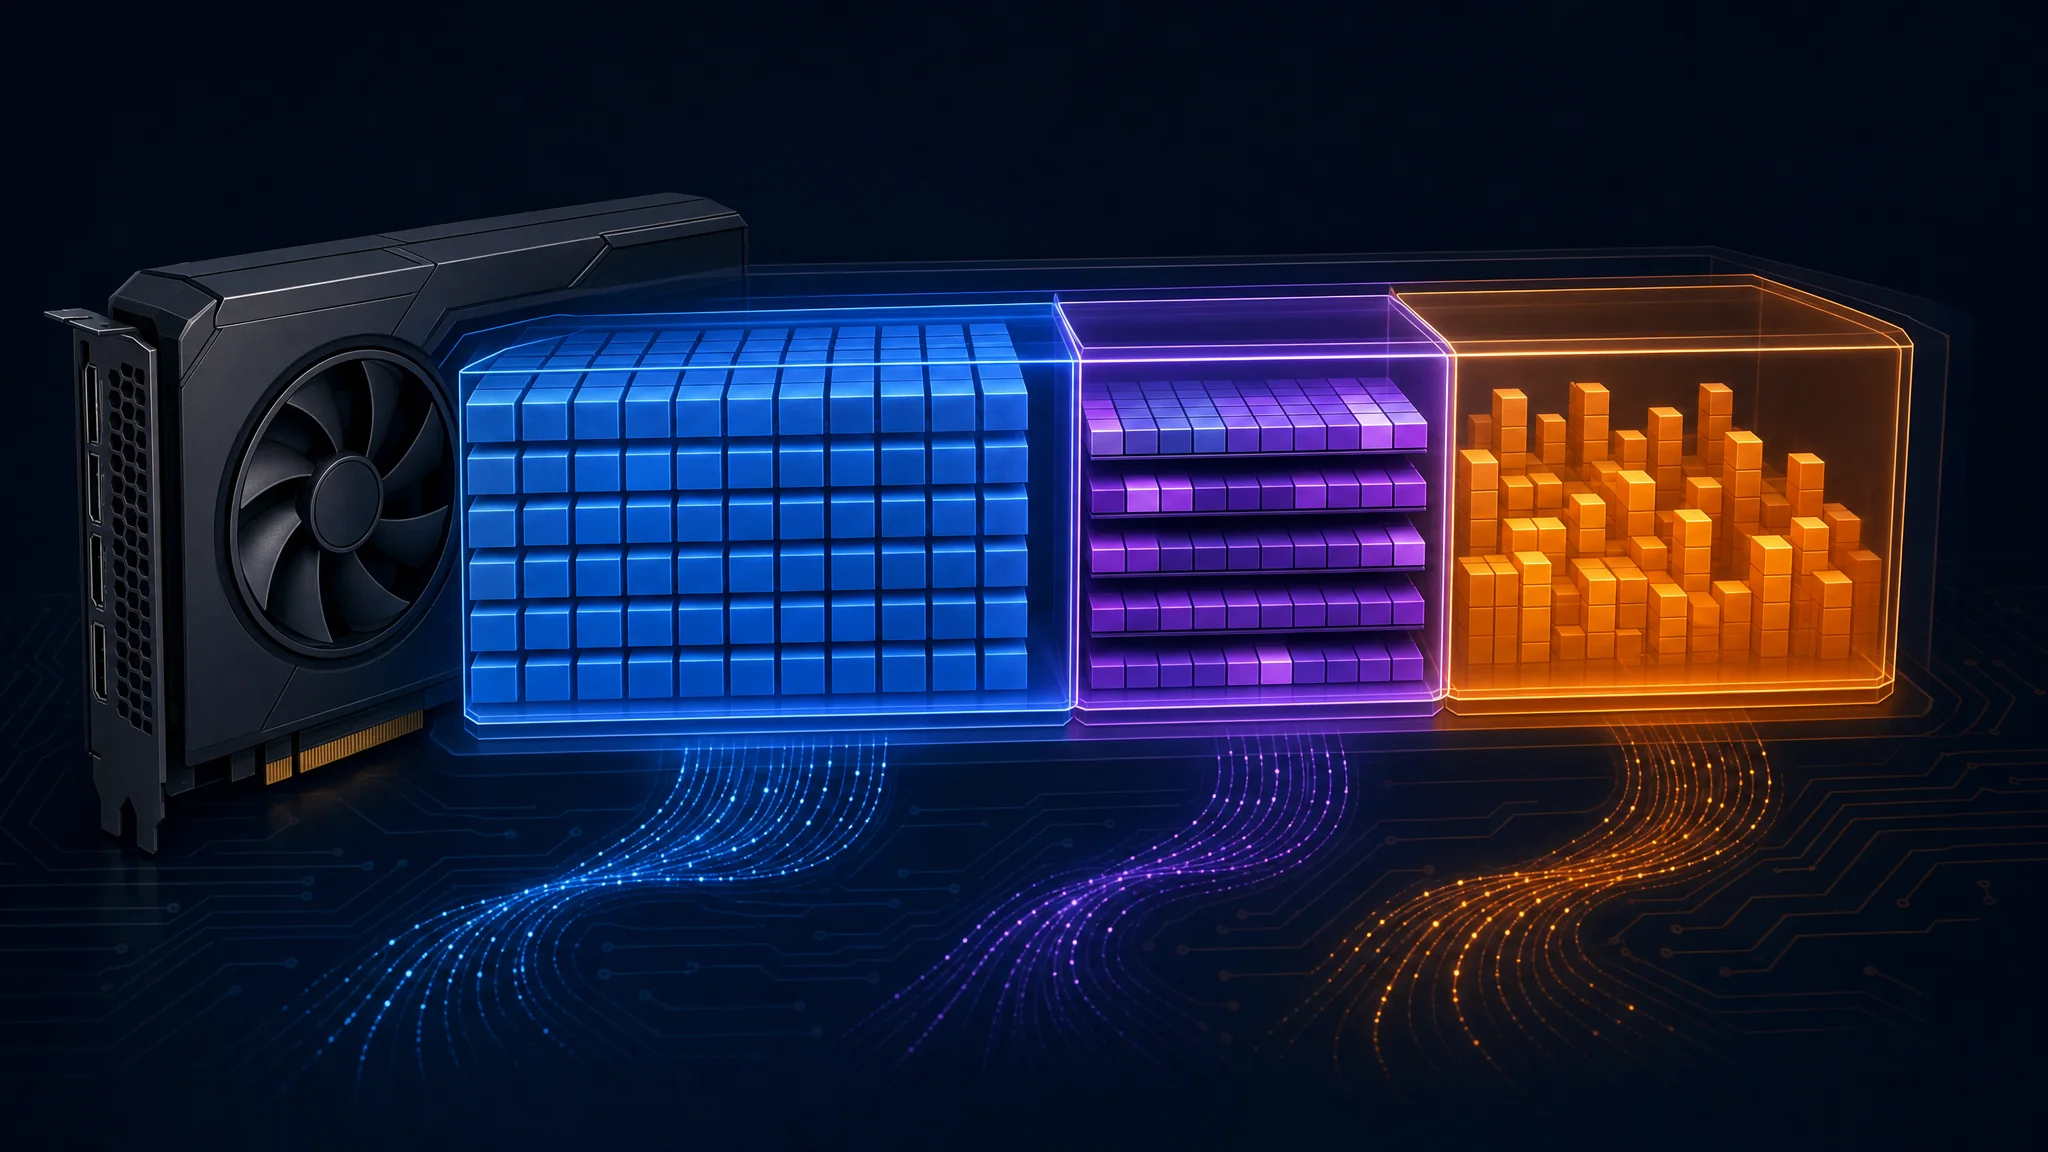
ਨੀਲਾ ਵਜ਼ਨ, ਜਾਮਨੀ context cache ਅਤੇ ਸੰਤਰੀ runtime allocations ਦਰਸਾਉਂਦਾ ਹੈ। ਆਕਾਰ ਉਦਾਹਰਨੀ ਹਨ
ਗਤੀਆਂ ਵੱਖਰੀਆਂ ਕਿਉਂ ਹਨ
16GB ਲੇਬਲ ਸਮਰੱਥਾ ਦੱਸਦਾ ਹੈ। Throughput memory bandwidth, compute kernels, active context, offload, batching ਅਤੇ speculative decoding ਉੱਤੇ ਵੀ ਨਿਰਭਰ ਕਰਦਾ ਹੈ।
| ਕਾਰਨ | ਕੀ ਜਾਂਚਣਾ ਹੈ |
|---|---|
| CPU ਜਾਂ RAM offload | Loaded layer placement ਅਤੇ cache location |
| ਲੰਬਾ context | Measurement ਵੇਲੇ occupied tokens |
| Backend ਫਰਕ | Runtime commit, driver ਅਤੇ kernel path |
| Speculative decoding | Accepted drafts ਅਤੇ extra allocations |
ਇੱਕ dense model ਲਈ ਜੋ ਇੱਕ ਵਾਰ ਵਿੱਚ ਇੱਕ token ਬਣਾਉਂਦਾ ਹੈ, resident weight bytes ਨਾਲ memory bandwidth ਨੂੰ ਭਾਗ ਦੇਣ ਨਾਲ rough estimate ਮਿਲਦਾ ਹੈ। 448 GB/s ਅਤੇ 11.8 GB weights ਉੱਤੇ quotient ਲਗਭਗ 38 tokens ਪ੍ਰਤੀ ਸਕਿੰਟ ਹੈ। Cache reads ਅਤੇ computation ਵਾਧੂ ਕੰਮ ਕਰਦੇ ਹਨ, ਜਦਕਿ speculative decoding ਅਤੇ batching ਧਾਰਣਾਂ ਬਦਲਦੇ ਹਨ।
ਇਸ quotient ਨੂੰ universal upper bound ਨਾ ਸਮਝੋ। ਵੱਧ output rate ਆਪਣੇ ਆਪ benchmark ਨੂੰ ਗਲਤ ਨਹੀਂ ਬਣਾਉਂਦੀ। ਜਾਂਚੋ ਕਿ target-model pass ਨੇ ਕਈ draft tokens ਸਵੀਕਾਰ ਕੀਤੇ ਸਨ ਜਾਂ ਨਹੀਂ।
Multi-token prediction, ਜਾਂ MTP, ਲਈ compatible model ਅਤੇ runtime ਚਾਹੀਦੇ ਹਨ। ਛੋਟੇ ਅਤੇ ਲੰਬੇ occupied context ਉੱਤੇ enabled ਅਤੇ disabled runs ਦੀ ਤੁਲਨਾ ਕਰੋ। ਵਾਧੂ weights ਅਤੇ draft state ਮੈਮੋਰੀ ਲੈਂਦੇ ਹਨ, ਪਰ 32K tokens ਤੋਂ ਬਾਅਦ MTP ਬੰਦ ਕਰਨ ਦਾ ਕੋਈ universal ਨਿਯਮ ਨਹੀਂ।
ਪਹਿਲਾ ਜਵਾਬ ਮਾਪੋ
Prefill generation ਤੋਂ ਪਹਿਲਾਂ prompt process ਕਰਦਾ ਹੈ। Decode answer ਬਣਾਉਂਦਾ ਹੈ। ਜਦ ਕੰਮ ਵੱਡੇ uncached prompt ਨਾਲ ਸ਼ੁਰੂ ਹੁੰਦਾ ਹੈ, fast decode slow first response ਨੂੰ ਲੁਕਾ ਸਕਦਾ ਹੈ।
Processing time ਦਾ ਅਨੁਮਾਨ ਲਾਉਣ ਲਈ uncached prompt tokens ਨੂੰ measured prefill throughput ਨਾਲ ਭਾਗ ਦਿਓ। Fresh 30,000-token prompt ਲਈ ਦੋ ਉਦਾਹਰਨੀ rates ਇਹ ਉਡੀਕ ਦਿੰਦੇ ਹਨ:
| Example prompt rate | Calculated processing time |
|---|---|
| 750 tokens/s | 40 seconds |
| 150 tokens/s | 200 seconds |
ਇਹ ਉਦਾਹਰਨ model loading ਅਤੇ request overhead ਤੋਂ ਬਿਨਾਂ processing time ਦੱਸਦੀਆਂ ਹਨ। Prompt length, batch size, model format ਅਤੇ backend measured rate ਨੂੰ ਪ੍ਰਭਾਵਿਤ ਕਰਦੇ ਹਨ।
Cold request ਅਤੇ reusable prefix ਵਾਲੀ continuation ਨੂੰ ਵੱਖਰੇ ਮਾਪੋ। Prefix reuse repeated input ਦਾ ਕੁਝ ਹਿੱਸਾ ਮੁੜ process ਨਹੀਂ ਕਰਦਾ। Time to first token, decode rate ਅਤੇ total task duration ਲਿਖੋ।
ਪੂਰੇ GPU ਸੈਟਅੱਪ ਦੀ ਤੁਲਨਾ ਕਰੋ
Purchase price, usable memory, bandwidth ਅਤੇ software path ਨੂੰ ਇਕੱਠੇ ਤੁਲਨਾ ਕਰੋ। ਜੇ workload ਨੂੰ unsupported features ਚਾਹੀਦੇ ਹਨ ਜਾਂ latency target ਤੋਂ ਵੱਧ ਸਮਾਂ ਲੱਗਦਾ ਹੈ ਤਾਂ ਘੱਟ ਕੀਮਤ ਵਾਲਾ card ਆਪਣਾ ਫਾਇਦਾ ਗੁਆ ਦਿੰਦਾ ਹੈ।
| 16GB desktop card | Memory bandwidth |
|---|---|
| RX 9060 XT | 320 GB/s |
| RTX 5060 Ti | 448 GB/s |
| RX 9070 | 640 GB/s |
| RX 9070 XT | 640 GB/s |
AMD ਦੀਆਂ RX 9070 specifications ਅਤੇ RX 9070 XT specifications 16GB capacity ਅਤੇ up-to-640 GB/s bandwidth confirm ਕਰਦੀਆਂ ਹਨ। 640-to-448 comparison ਲਗਭਗ 43% ਵੱਧ theoretical bandwidth ਦਿੰਦਾ ਹੈ। ਇਹ specifications 43% inference improvement ਸਾਬਤ ਨਹੀਂ ਕਰਦੀਆਂ।
ਆਪਣੇ intended model ਅਤੇ backend ਵਾਲੇ benchmarks ਚੁਣੋ। Short prompts ਅਤੇ sustained generation ਲਈ decode performance ਨੂੰ ਵੱਧ ਭਾਰ ਦਿਓ। Repository analysis ਲਈ cold prefill, long-context speed ਅਤੇ successful task completion ਨੂੰ ਪਹਿਲ ਦਿਓ। ਕਿਸੇ vendor ਨੂੰ ਖਰੀਦਣ ਤੋਂ ਪਹਿਲਾਂ available software ਜਾਂਚੋ।
Macs ਅਤੇ laptop labels
16GB Apple silicon Mac CPU, GPU, operating system ਅਤੇ applications ਵਿਚਕਾਰ memory ਸਾਂਝੀ ਕਰਦਾ ਹੈ। Discrete 16GB GPU ਕੋਲ system RAM ਤੋਂ ਇਲਾਵਾ dedicated video memory ਹੁੰਦੀ ਹੈ। ਇਹ capacities equivalent model budgets ਨਹੀਂ ਦੱਸਦੀਆਂ।
Apple ਇੱਕ recommended GPU working-set size ਦਿੰਦਾ ਹੈ। Runtime allowance ਅਤੇ system memory pressure ਵੇਖੋ। Shared pool ਨੂੰ ਸਾਰਾ inference ਲਈ ਰੱਖਣ ਦੀ ਬਜਾਏ macOS ਅਤੇ ਹੋਰ applications ਲਈ ਜਗ੍ਹਾ ਛੱਡੋ।
Laptops ਲਈ manufacturer ਦਾ exact SKU, dedicated memory, GPU power limit ਅਤੇ cooling ਜਾਂਚੋ। NVIDIA RTX 5060 family page desktop RTX 5060 Ti memory variants ਦੱਸਦੀ ਹੈ। Family name ਇਕੱਲਾ 16GB ਸਾਬਤ ਨਹੀਂ ਕਰਦਾ ਅਤੇ desktop results laptop throughput ਸਾਬਤ ਨਹੀਂ ਕਰਦੇ।
ਕੀ ਮਾਲਕੀ ਲਾਭਦਾਇਕ ਹੈ?
ਮਾਲਕੀ ਵਿੱਤੀ ਤੌਰ ਤੇ ਤਦ ਲਾਭਦਾਇਕ ਹੈ ਜਦੋਂ ਬਚੀਆਂ hosting charges operating costs ਤੋਂ ਵੱਧ ਹੋਣ ਅਤੇ hardware purchase ਵਾਪਸ ਆ ਜਾਵੇ। Output-only ਉਦਾਹਰਨ ਨਾਲ ਸ਼ੁਰੂ ਕਰੋ: $789 card, 35 output tokens/s, generation ਵੇਲੇ 180W, $0.18/kWh electricity ਅਤੇ $2.95 ਪ੍ਰਤੀ million hosted output tokens। ਇਹ illustrative inputs ਹਨ। ਇਨ੍ਹਾਂ ਨੂੰ ਆਪਣੀ purchase quote, measured power, electricity rate ਅਤੇ provider pricing ਨਾਲ ਬਦਲੋ।
Hours per million output tokens = 1,000,000 ÷ 35 ÷ 3,600 = 7.94
Electricity per million = 7.94 × 0.180 kW × $0.18/kWh = $0.257
Savings per million = $2.95 - $0.257 = $2.693
Break-even output = $789 ÷ $2.693 = 293 million tokens
Continuous generation time = 293 × 7.94 ÷ 24 = about 97 days
ਰੋਜ਼ ਅੱਠ ਘੰਟੇ ਲਗਾਤਾਰ generation ਉੱਤੇ ਇਹੀ ਗਣਨਾ ਲਗਭਗ 291 ਦਿਨ ਲੈਂਦੀ ਹੈ। Assistant ਖੁੱਲ੍ਹਾ ਰੱਖਣ ਦੇ ਅੱਠ ਘੰਟੇ tokens generate ਕਰਨ ਦੇ ਅੱਠ ਘੰਟਿਆਂ ਵਰਗੇ ਨਹੀਂ ਹਨ।
Hosted output price $0.16 ਪ੍ਰਤੀ million ਹੋਣ ਤੇ ਇਸ scenario ਵਿੱਚ local electricity hosting ਤੋਂ ਮਹਿੰਗੀ ਹੈ। ਇਨ੍ਹਾਂ ਧਾਰਣਾਂ ਹੇਠ output-only positive break-even point ਨਹੀਂ ਹੈ।
ਚੁਣੇ provider ਦੀਆਂ current OpenRouter model prices ਵਰਤੋ, input ਅਤੇ cached-input charges ਸਮੇਤ। Prefill ਸਮੇਤ ਪੂਰੇ system ਦੀ energy ਮਾਪੋ। Upgrades, idle energy, maintenance ਅਤੇ expected resale value ਜੋੜੋ। Accepted work ਦੀ ਤੁਲਨਾ ਕਰੋ, ਕਿਉਂਕਿ retries ਅਤੇ quality differences task cost ਬਦਲਦੇ ਹਨ।
ਮੈਮੋਰੀ ਕਦੋਂ ਜੋੜਨੀ ਹੈ
ਜਦ measured workload acceptable quality ਅਤੇ latency ਉੱਤੇ available context ਤੋਂ ਵੱਧ ਜਾਵੇ ਤਾਂ 16GB ਤੋਂ ਅੱਗੇ ਜਾਓ। Daily long agent sessions, concurrent requests ਜਾਂ higher-precision weights ਵੱਧ capacity ਨੂੰ ਲਾਭਦਾਇਕ ਬਣਾਉਂਦੇ ਹਨ।
ਦੋ 16GB cards ਲਈ explicit runtime support ਚਾਹੀਦਾ ਹੈ। ਇਹ transparent 32GB allocation ਨਹੀਂ ਬਣਦੇ। ਹਰ device ਨੂੰ buffers ਚਾਹੀਦੇ ਹਨ ਅਤੇ communication host interconnect ਵਰਤਦੀ ਹੈ।
| Split strategy | ਮੁੱਖ tradeoff |
|---|---|
| Layer split | ਵੱਖਰੀਆਂ layers ਵੱਖਰੇ devices ਉੱਤੇ ਰਹਿੰਦੀਆਂ ਹਨ |
| Tensor ਜਾਂ row split | Layers ਅੰਦਰ ਕੰਮ communication ਜੋੜਦਾ ਹੈ |
| CPU plus GPU | ਵੱਖਰੇ latency profile ਨਾਲ ਵੱਧ capacity |
ਜਦ motherboard, power supply, cooling ਅਤੇ backend plan ਨੂੰ support ਕਰਦੇ ਹੋਣ ਤਾਂ second card ਵਿਚਾਰੋ। Complete system cost ਨੂੰ ਵੱਡੇ single GPU ਨਾਲ ਤੁਲਨਾ ਕਰੋ। 32GB Qwen hardware guide ਇਹ alternatives ਦੱਸਦੀ ਹੈ।
Troubleshooting ਅਤੇ ਅਗਲੇ ਕਦਮ
ਜੇ loading fail ਹੋਵੇ ਤਾਂ context ਘਟਾਓ ਅਤੇ allocations ਵੇਖੋ। ਜੇ session ਦੌਰਾਨ speed ਘਟੇ ਤਾਂ occupied context ਅਤੇ CPU offload ਜਾਂਚੋ। ਜੇ first response ਰੁਕ ਜਾਵੇ ਤਾਂ cold prefill ਮਾਪੋ। ਜੇ compression ਤੋਂ ਬਾਅਦ tool use ਟੁੱਟੇ ਤਾਂ ਉਹੀ task higher-precision model ਨਾਲ ਤੁਲਨਾ ਕਰੋ।
ਆਪਣੀਆਂ normal instructions, files ਅਤੇ tool outputs ਵਾਲਾ repeatable test ਸੰਭਾਲੋ। Model revision, runtime version, cache precision, occupied context, peak memory, first-token latency, decode speed ਅਤੇ task pass ਹੋਇਆ ਜਾਂ ਨਹੀਂ ਲਿਖੋ। ਸਭ ਤੋਂ ਲੰਬੇ expected session ਦੇ ਨੇੜੇ ਮੁੜ ਟੈਸਟ ਕਰੋ।
local model and context guide ਨਾਲ ਛੋਟੇ alternatives ਦੀ ਤੁਲਨਾ ਕਰੋ। Quality requirements ਪੂਰੇ ਕਰਨ ਵਾਲਾ ਸਭ ਤੋਂ ਛੋਟਾ model ਚੁਣੋ ਅਤੇ complete task ਲਈ ਕਾਫ਼ੀ memory ਰੱਖੋ। ਇਹਨਾਂ ਹਾਲਾਤਾਂ ਵਿੱਚ 16GB workstation ਲਈ ਵਰਤੋਂਯੋਗ target ਹੈ।
Related Posts